흩어진 테크 블로그 글을 한곳에서 찾아 읽어요
여러 기술 블로그의 새 글을 제목·요약·태그로 검색하고 주제별·블로그별로 살펴볼 수 있어요. 글 상세와 원문은 로그인 없이 볼 수 있고, 로그인하면 읽음 표시와 즐겨찾기를 동기화하고 개인 노트를 저장할 수 있어요.
여러 기술 블로그의 새 글을 제목·요약·태그로 검색하고 주제별·블로그별로 살펴볼 수 있어요. 글 상세와 원문은 로그인 없이 볼 수 있고, 로그인하면 읽음 표시와 즐겨찾기를 동기화하고 개인 노트를 저장할 수 있어요.
3년 동안 쌓이기만 하던 원티드 앱 리뷰에 다시 답글을 달기 시작했다. 원티드 Android, iOS 앱 리뷰는 거의 3년째 방치되어 있었습니다. 조직 개편이 진행되는 동안 누가 담당자인지 모호해졌습니다. 다들 언젠가 해야 한다고는 생각했지만 막상 누구 일도 아닌 상태로 시간이 흘렀 버렸습니다. 그러던 중 iOS개발자였던 찬주님이 슬랙에 위와 같은 아이디어를 올렸고, Android도 동일한 상황이라 이번에 앱 개발자 두 명(Android, iOS)이 직접 이 일을 정리해 보기로 했습니다. 일주일 동안 만든 건 이런 사이트 입니다. 하는 일은 단순합니다. 1시간마다 App Store와 Google Play에서 새 리뷰를 가져온다. 새 리뷰를 Slack 채널에 올리고, AI가 쓴 답글 초안을 스레드에 단다. 사람이 초안을 읽고 승인 이모지를 누르면 스토어에 답글이 올라간다. 버그 제보나 기능 제안이면 이모지 하나로 Jira 이슈를 만든다. Web에서는 리뷰를 걸러 보고, 답글을 고쳐서 게시하고, 통계를 본다. AI가 답글을 쓰긴 하지만 사람이 확인하지 않은 답글은 절대 올라가지 않습니다. 스토어 답글은 한 번 게시하면 사용자에게 바로 전달되기 때문에 이것만큼은 처음부터 정해 두고 시작했습니다. 스펙은 화면을 보면서 정했다 이 프로젝트에는 기획자도 디자이너도 없었습니다. 일단 스펙 문서부터 작성했지만 문서만으로는 자연스럽게 소통하기 힘들었습니다. 그래서 스펙을 Claude에게 보여 주고 이렇게 부탁했습니다. [문서]의 기능을 만들 건데, Claude Design에게 시킬 프롬프트를 작성해 줘. 프롬프트를 Claude Design에 넣자 리뷰 목록, 상세, 게시 확인, 통계, 배치 상태 화면까지 초안이 한 번에 나왔습니다. 여기서부터는 화면을 같이 보면서 바로바로 피드백을 주고받을 수 있었습니다. “통계에 Jira 이슈 수도 넣자”, “목록에서는 답글 게시 전 초안을 숨기자”, “게시 버튼 앞에 내용을 끝까지 확인했다는 체크를 두자” 같은 이야기가 화면 위에서 나왔고, 그렇게 정한 내용을 스펙으로 옮겼습니다. 글로만 논의할 땐 나오지 않던 피드백들이 자연스럽게 쏟아져 나왔습니다. Montage 디자인 시스템도 큰 역할을 했습니다. Claude Design에 원티드 디자인 시스템인 Montage를 연결해 두었더니 첫 초안부터 기존 원티드 서비스와 같은 버튼, 색, 글꼴로 나왔습니다. 웹 화면도 사내 표준 스택(Next.js + Montage)을 따랐기 때문에 목업을 코드로 옮길 때 같은 컴포넌트를 그대로 가져다 쓸 수 있었습니다. 디자이너 없이 만든 화면인데 어색하지 않은 건 Montage 덕분입니다. 사내 도구를 이어 붙여서 만들었다 Backyard: 웹 프론트, API 서버, DB Backyard는 원티드랩 사내 구성원들을 위한 샌드박스 실행 환경입니다. Kubernetes(이하 k8s) 위에서 돌아가고, 프로젝트를 하나 만들면 그 프로젝트만 쓰는 공간이 생깁니다. 그 안에서 웹 프론트엔드, 백엔드 API 서버, MySQL DB를 켜고 끌 수 있고, 필요하면 Redis와 S3 저장소도 붙일 수 있습니다. 각 구성 요소는 컨테이너로 뜨고, k8s 배포 설정, 서비스, 도메인 연결은 Backyard가 대신 만듭니다. Backyard가 MCP를 제공해주기 때문에 개발자는 k8s 설정 파일을 쓸 필요 없이 자연어로 “이 프로젝트에 프론트, 백엔드, DB를 켜줘.” 라고만 말해도 알아서 세팅해 줍니다. 배포는 도커 이미지를 올리는 것으로 끝납니다. 프로젝트 전용 레지스트리에 latest 태그로 이미지를 push하면, Backyard가 이를 감지해 실행 중인 컨테이너를 새 이미지로 차례로 교체합니다. 이 또한 자연어로 “Backyard로 배포해줘"라고만 말하면 됩니다. 덕분에 서버 신청이나 DB 발급을 기다릴 필요가 없었고, 킥오프 당일에 백엔드와 DB가 이미 떠 있었습니다. Ennoia: AI 에이전트 Ennoia는 원티드에서 운영하는 AI 에이전트 플랫폼으로, 에이전트를 자연어로 쉽게 만들 수 있습니다. 여기에 에이전트를 만들
 Amazon Web Services 한국 블로그
주요소식 The Story of VS Code Visual Studio Code 공식 채널이 공개한 약 1시간 38분 분량의 다큐멘터리로, Erich Gamma가 이끈 취리히 팀이 브라우저용 편집기 컴포넌트 Monaco Editor를 만들던 시기부터 데스크톱 VS Code 발표와 오픈 소스 전환까지의 과정을 30여 명의 관계자 인터뷰로 보여 준다. 확장을 별도 프로세스에서 실행하고 한번 공개한 API는 바꾸지 않는 원칙, TypeScript 서버에서 출발한 LSP, UI와 확장 호스트를 분리한 구조가 원격 개발과 vscode.dev로 이어진 배경을 설명한다. 후반부에서는 GitHub Copilot의 출발과 Ask, Edits, Agent Mode로 이어진 AI 기능, Cursor 같은 포크를 바라보는 VS Code 팀의 시각도 소개한다. Native is now the future of mobile at Shopify 2020년 React Native 전면 도입을 선언했던 Shopify가 모바일 앱을 다시 Swift와 Kotlin 네이티브로 옮긴다고 발표했다. 코딩 에이전트 덕분에 두 플랫폼에 각각 구현하는 비용이 줄면서 공유 구현보다 네이티브의 이점이 커졌다는 판단으로, Shop 앱은 12주 만에 재구축했고 화면을 작은 체크포인트로 나눠 테스트, 시각 비교, 적대적 코드 리뷰, 사람의 승인을 거치게 하는 Helix 시스템을 만들었다. React Native Skia, FlashList, Restyle 등 Shopify가 관리해 온 오픈소스의 향후 계획도 공개해, 이 라이브러리를 쓰는 프로젝트라면 전환 일정을 확인해 둬야 한다. 토스 FE 개발자들의 검증법 토스 웨비나에서 Front AI 팀이 AI로 만든 결과물을 검증하는 방법을 소개한 세션이다. 코드에서 시나리오를 추론해 E2E 테스트를 자동 생성하려던 시도가 실패한 뒤, 얼굴 인식 결제처럼 실수 비용이 큰 영역에서 테스트를 직접 작성하며 디바이스 팜 조작 도구, 액션 로그 조회 스킬처럼 테스트를 막던 요소를 해결하는 도구를 만들어 온 과정을 설명한다. 사람이 CI 실패 원인을 파악하도록 만든 replay 도구를 에이전트에 그대로 넘기자 버튼 문구 변경 같은 실패를 스스로 고쳤다는 경험은 AI 검증 체계를 고민하는 FE 팀이 참고할 만하다. penpot 브라우저에서 쓰거나 직접 설치해 운영할 수 있는 오픈소스 디자인, 프로토타이핑 플랫폼이다. 디자인을 SVG, CSS, HTML 같은 개방형 표준으로 표현하고 CSS Grid와 Flex 레이아웃, 디자인 토큰, 컴포넌트를 기본 기능으로 제공하며, MCP 서버를 통해 Cursor나 Claude Code 같은 AI 에이전트가 컴포넌트, 토큰, 레이어 구조를 읽고 수정할 수 있다. 셀프 호스팅이 가능해 디자인 데이터를 사내에 두어야 하는 조직이 검토해 볼 만한 MPL-2.0 라이선스 프로젝트다. Full Course: Spec-Driven Development with Coding Agents DeepLearning.AI와 JetBrains가 만든 명세 주도 개발(Spec-Driven Development) 강좌의 전체 영상으로, 마크다운 명세를 먼저 쓰고 코딩 에이전트가 이를 구현하게 하는 흐름을 WebStorm과 Claude Code로 Next.js 예제 앱을 만들며 보여 준다. mission.md, techstack.md, roadmap.md로 프로젝트 헌장을 만든 뒤 기능마다 명세를 작성하고 컨텍스트를 비운 상태에서 구현을 맡기는 반복 과정을 설명한다. 기존 코드베이스에서 헌장을 역으로 만드는 방법과 Spec Kit, OpenSpec 같은 공개 SDD 도구도 소개해, 코딩 에이전트 결과물의 일관성을 고민하는 개발자에게 도움이 된다. >> FE News 26년 10월 소식 보러가기 ◎ FE News란? 네이버 FE 엔지니어들이 엄선한 양질의 FE 및 주요한 기술 소식들을 큐레이션해 공유하는 것을 목표로 하며, 이를 통해 국내 개발자들에게 지식 공유에 대한 가치 인식과 성장에 도움
26년 9월 소식에서는 다음과 같은 유용한 정보들을 만나보실 수 있습니다. 주요소식 The AI Engineering Skills Map Andrew Ng이 DeepLearning.AI 팀과 함께 1만 건이 넘는 채용 공고 분석과 전문가 인터뷰, 설문을 종합해 정리한 AI 엔지니어링 역량 지도다. AI 애플리케이션 구축·배포, 소프트웨어 엔지니어링 기본기, 코딩 에이전트 활용, 그리고 무엇을 만들지 정하는 일(shaping the build) 네 가지를 지금 익힐 가치가 큰 역량으로 꼽는다. 저자는 이 역량들이 "AI 엔지니어"라는 직함에 한정되지 않고 풀스택, 데이터, DevOps를 포함한 모든 개발자에게 필요해진다고 보며, 앞으로 무엇을 학습 우선순위에 둘지 고민하는 개발자에게 참고할 만한 정리다. How We Migrated lovable.dev Away from Next.js 월 4,200만 방문 규모의 lovable.dev를 Next.js에서 Cloudflare workerd 런타임 위의 TanStack Start로 옮긴 기록이다. 전면 재작성 대신 6개월간 두 프레임워크를 동시에 운영하면서 프록시 워커가 라우트 단위로 분기하도록 하고, 사용자 여정에 따라 묶은 라우트 그룹을 순차 전환했으며 실제 코드 이전은 대부분 AI 에이전트가 처리했다. 빌드 시간은 6~9분으로 줄고 중위 TTFB는 49% 빨라졌으며 개발 환경 메모리 사용량은 8GB에서 1.5GB로 내려간 수치도 함께 공개해, 대규모 프로덕션 앱의 프레임워크 전환을 무중단으로 진행하는 방법론으로 참고할 만하다. How AI text watermarking works: a visual guide AI가 생성한 텍스트에 눈에 보이지 않는 표식이 어떻게 새겨지는지를 다섯 단계로 나눠 시각적으로 설명하는 가이드다. 워터마크는 글자가 아니라 단어와 단어 사이의 선택에 숨는데, 비밀 키로 후보 단어를 초록과 빨강으로 나누고 초록 쪽으로 확률을 살짝 기울인 뒤 검출 시 같은 방식으로 다시 색을 칠해 초록 비율을 세는 방식이다. 가벼운 편집은 표식을 희석하는 정도지만 표현이 겹치지 않게 다시 쓰면 사실상 지워지고, 키를 가진 쪽만 검증할 수 있어 공개된 "AI 탐지기" 사이트로는 확인할 수 없다는 실무적인 한계도 함께 짚는다. Bun 1.4 Bun 1.4의 헤드라인은 코어를 Zig에서 Rust로 재작성한 것이다. 시작 시간은 Linux에서 2배, Windows에서 2.5배 빨라졌고 HTTP 서버의 메모리 사용량은 13~48% 줄었다. 내장 헤드리스 브라우저 자동화(Bun.WebView), Bun.Image, Bun.markdown, Terminal과 cron API가 추가되었고 Node.js 26.3.0 호환으로 1,517개 테스트가 새로 통과한다. React 사용자에게 눈에 띄는 것은 React Compiler 지원으로, Babel이나 SWC를 거치지 않고 Bun 자체 파서 안에서 컴파일러가 돌기 때문에 약 860개 컴포넌트 규모의 코드베이스에서 빌드 시간이 71ms 늘어나는 데 그쳐 Babel 플러그인 대비 약 20배 빠르다. Next.js 16.3 Next.js 16.0 이후 가장 큰 업데이트로, 코드 변경 없이 얻는 개선과 옵트인 기능이 함께 담겼다. dev 서버는 Turbopack의 디스크 캐싱과 메모리 축출이 기본 활성화되어 메모리 사용량이 최대 90% 줄었고, next build에도 디스크 캐싱이 적용되어 CI 반복 빌드가 최대 5.5배 빨라졌다. 옵트인 기능인 Instant Navigations는 cacheComponents와 partialPrefetching 플래그를 켜면 Suspense 인라인 로딩 상태나 'use cache'로 표시한 UI를 추출해 내비게이션 전에 클라이언트로 실어 보내, 서버 주도 모델을 유지하면서 SPA 수준의 반응성을 확보한다. 이 외에 retry()로 서버 컴포넌트를 다시 가져올 수 있는 catchError 에러 바운더리, Vite 호환 import.meta.glob, root params가 추가되었
 블로그
이 글은 C#/Unity 경험이 없는 프론트엔드 개발자가 운영 중인 Unity 서비스를 React/Next로 마이그레이션하며, 검증 지점을 코드에서 자연어 명세로 옮긴다는 발상을 바탕으로 AI 협업 흐름 전체를 설계한 과정을 다룹니다. 특히 읽지 못하는 원본 코드를 AI가 관측 가능한 동작 중심의 명세로 번역하고, 그 명세를 구현·검증·리뷰가 참조하는 단일 기준으로 삼는 하네스 엔지니어링 접근을 설명합니다. 또한 iOS Safari의 한글 IME 이슈 사례를 통해 AI가 제시하는 '가장 흔한 정답'이 내 상황에 맞는지는 개발자가 판단해야 함을 보여주고, 단락 단위 가상 스크롤 전환 과정에서 AI를 "가설을 싸게 만들고 빠르게 버리는" 도구로 활용하는 구체적인 방법을 다룹니다. 나아가 hook 기반 자동 안전장치와 도메인별 AI 리뷰어 분리, 그리고 자율성을 의도적으로 제한한 트레이드오프 판단까지, 정확성이 중요한 마이그레이션 작업에서 AI에게 어디까지 맡길지 정하는 판단력을 실무적 관점에서 살펴보는 글입니다.
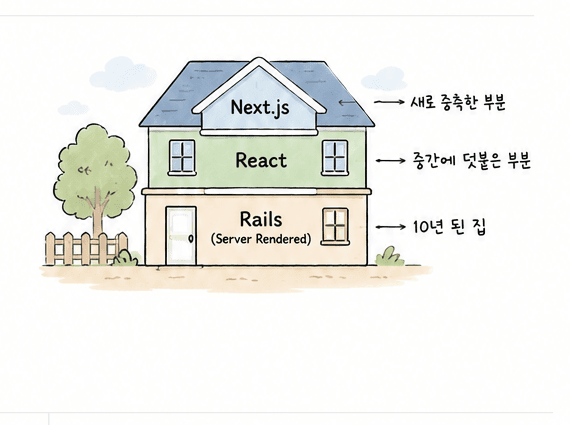
WORXPHERE 끝나지 않는 AI 에이전트 루프를 멈추기까지 React On Rails → Next.js 마이그레이션으로 시작한 루프 엔지니어링 안녕하세요. 웍스피어에서 잡플래닛 서비스를 담당하고 있는 프론트엔드 개발자 강태완입니다. 잡플래닛은 10년 넘게 운영된 서비스입니다. 오랜 시간 서비스를 운영하면서 Rails 위에 React가 붙고, 거기에 Next.js까지 들어왔습니다. 지금의 프론트엔드를 아주 단순하게 표현하면 대략 이런 구조입니다. 오래된 화면은 Rails가 렌더링하고, 그 안에서 React 컴포넌트가 동작합니다. 페이지를 이동하면 React가 들고 있던 상태도 함께 사라집니다. 한 페이지 안에서는 React를 사용하고 있지만, 페이지를 넘어 상태를 이어가기는 어렵습니다. 이전 단계의 값을 다시 전달하거나 복원하는 별도의 처리가 필요해서 페이지가 이어질수록 처리도 복잡해졌습니다. SEO도 비슷했습니다. 못 하는 건 아니지만, Rails와 React에 렌더링이 나뉘어 있다 보니 페이지마다 따로 챙겨야 할 부분이 있었습니다. 이런 불편함 때문에 지금은 오래된 Rails 페이지를 하나씩 Next.js로 옮기고 있습니다. 그런데 마이그레이션 기간이 길어질수록 또 다른 문제가 생겼습니다. 아직 안 옮긴 페이지는 Rails에 있고, 옮긴 페이지는 Next.js에 있습니다. 예를 들어 Rails와 Next.js 양쪽에서 공통으로 노출되는 상단 GNB를 수정하려면 두 프로젝트를 모두 수정해야 합니다. 한쪽만 고치면요? 당장은 아무 일도 일어나지 않습니다. 그리고 한참 뒤에 누군가 발견합니다. “어? 여기랑 저기 UI가 다른데요?” 그때 알게 됩니다. 아, 한쪽만 고쳤구나. 그래서 가능한 한 빨리 마이그레이션을 끝내는 것 자체가 이중 관리 비용을 줄이는 방법이었습니다. 문제는 옮겨야 할 페이지가 한두 개가 아니었다는 겁니다. 페이지마다 원본을 확인하고, Next.js로 구현하고, 다시 원본과 비교하는 비슷한 작업이 계속 반복됐습니다. 이 반복을 좀 줄여보고 싶어서 AI 에이전트를 사용하기 시작했습니다. 에이전트를 썼는데, 제가 더 바빠졌습니다 처음에는 단순하게 생각했습니다. “이 Rails 페이지를 Next.js로 옮겨줘.” 에이전트가 구현하면 결과를 확인하고, 다른 부분이 보이면 다시 요청했습니다. 수정이 끝나면 또 확인했습니다. 페이지 하나를 옮기는 데도 이 과정을 몇 번씩 반복해야 했습니다. 페이지가 많아지니 제가 확인해야 할 결과도 같이 늘어났고요. 에이전트를 쓰면 제가 편해져야 하는데, 제가 계속 에이전트를 감시하고 있었습니다. AI가 코드를 쓰는 속도보다 사람이 결과를 확인하는 속도가 느렸습니다. 병목은 에이전트가 아니라 사람 쪽에 있었습니다. 그러다 루프 엔지니어링에 대한 이야기를 접했고, 아이디어는 단순했습니다. 에이전트에게 사람이 매번 프롬프트하지 말고, 에이전트에게 프롬프트하는 프로그램을 만들자. 생각해보니 마이그레이션은 이 방식과 꽤 잘 맞아 보였습니다. 이미 원본 Rails 페이지가 있습니다. Next.js로 구현하고, 원본과 비교하고, 다르면 다시 고치면 됩니다. 그래서 사람이 반복하던 요청과 확인을 루프로 옮기기 시작했습니다. Workflow({ scriptPath: '.claude/workflows/rails-migration-loop.js', args: { page: 'welfare-review-write', phase: 'verify', }, }) 구현과 검증을 반복하다 보면 자연스럽게 원본에 가까워지고, 어느 순간 끝날 거라고 생각했습니다. 처음 돌려본 결과는 꽤 인상적이었습니다. 루프가 안 멈췄습니다. “더 고칠 게 있어?”라고 물으면 영원히 끝나지 않는다 첫 시도는 사실상 무한 루프였습니다. 루프에게 준 목표는 단순했습니다. “이 페이지를 Next.js로 옮겨줘.” 문제는 그다음이었습니다. 루프는 매 라운드마다 에이전트에게 “더 고칠 게 있어?”라고 물었습니다. 그러면 에이전트는 항상 고칠 것을 찾아냈습니다. “여백이 2px 정도 어색합니다.” 그걸 고치면 다음에는 타입을 조금
주요소식 26년 6월 소식에서는 다음과 같은 유용한 정보들을 만나보실 수 있습니다. TypeScript 7.0 RC Go로 재작성된 네이티브 컴파일러를 탑재한 TypeScript 7.0의 릴리스 후보(RC)가 공개되었다. 기존 타입 체크 로직과 구조를 그대로 유지한 채 포팅해 6.0보다 약 10배 빠르며, Bloomberg, Figma, Google, Slack, Vercel 등 여러 기업의 팀과 프리릴리스 빌드를 테스트해 왔다. 향후 한 달 내 정식 릴리스될 예정으로, 대규모 코드베이스에서 타입 체크와 빌드 속도로 고생해 온 팀이라면 미리 검증해 볼 가치가 있다. Ship the policy, not the code 프런트엔드와 백엔드처럼 별도로 배포되는 두 시스템에 동일한 비즈니스 규칙을 구현할 때 발생하는 코드 중복과 불일치 문제를 다룬다. 백엔드가 "allowedActions": ["CANCEL"] 같은 결정값을 내려보내거나, CASL이나 JSON Schema 같은 표준 형식으로 정책 자체를 데이터로 직렬화해 전송하는 방안을 제시한다. 마이크로서비스나 BFF 구조에서 규칙 일관성을 고민하는 개발자에게 실용적인 관점을 제공한다. Getting started with loops Claude Code 팀이 코딩 에이전트에게 프롬프트를 반복 입력하는 대신 "루프를 설계"하는 접근을 정리한 글이다. 트리거 방식과 종료 기준에 따라 턴 기반, 목표 기반, 시간 기반, 프로액티브 4가지 유형으로 분류하고, 검증 절차를 스킬(SKILL.md)로 인코딩해 자가 검증 능력을 높이는 방법을 소개한다. 명확한 종료 기준 설정과 대규모 실행 전 파일럿 테스트 등 토큰 사용량 관리 팁도 함께 제안한다. React Doctor AI 에이전트가 작성한 React 코드의 품질 문제를 자동으로 잡아내는 도구다. 상태 관리, 이펙트, 성능, 아키텍처, 보안, 접근성 전반을 검사하며 Next.js, Vite, TanStack, React Native, Expo 등 대부분의 React 환경을 지원한다. Claude Code, Cursor, Codex 같은 AI 에이전트와 연동되고, GitHub Actions를 통한 PR 자동 리뷰도 가능하다. vercel/eve Vercel이 공개한 파일시스템 기반의 지속형(persistent) AI 에이전트 프레임워크다. 시스템 프롬프트는 instructions.md, 도구는 tools/, 온디맨드 절차는 skills/ 디렉터리에 두는 식으로 에이전트의 구성 요소를 코드가 아닌 디렉터리 구조로 관리해 검사와 확장이 쉽다. 마크다운과 타입 정의된 함수만으로 에이전트를 구성하는 접근은 코드 중심 프레임워크 대비 낮은 진입 장벽을 제공한다. >> FE News 26년 7월 소식 보러가기 ◎ FE News란? 네이버 FE 엔지니어들이 엄선한 양질의 FE 및 주요한 기술 소식들을 큐레이션해 공유하는 것을 목표로 하며, 이를 통해 국내 개발자들에게 지식 공유에 대한 가치 인식과 성장에 도움을 주고자 하는 기술소식 공유 프로젝트 입니다. 매월 첫째 주 수요일, 월 1회 발행 되고 있으니 많은 관심 부탁드립니다. ▷ 구독하기
안녕하세요. 네이버페이 금융FE 팀의 정회원입니다. 사내 ENGINEERING DAY 2026에서 발표한 “AI 에이전트를 위한 Playwright E2E 테스트 하네스 구축하기” 내용을 글로 옮기고 일부 설명을 덧붙였습니다. 발표 영상은 NAVER D2나 YouTube에서 보실 수 있습니다. 검증이 병목이다 2026년, AI가 코드를 짜는 시대가 되며 코딩은 확실히 빨라졌습니다. 제가 주로 작업하는 코드베이스에서 개발자 한 명이 머지한 PR을 세어봤더니, AI 도구를 본격 도입하기 전 9개월은 227건, 도입 후 9개월은 348건으로 1.5배가 됐습니다. 그럼 PR이 늘어난 만큼, 검증도 1.5배 더 잘 되고 있을까요? 한번은 에이전트에게 Next.js 버전 업그레이드를 맡겼더니 얼마 뒤 ‘문제없이 완료했습니다.’ 라고 보고하고 PR도 작성했습니다. 그런데 막상 돌려보니 특정 페이지에서 뒤로가기를 눌렀을 때 기존 동작이 깨져 있었습니다. 프레임워크 내부 구현이 바뀌면서 기존 기능이 영향을 받은 것인데, 에이전트는 이걸 확인하지 않은 채 ‘끝났다’고 보고한 것입니다. 여러분도 누군가가 바이브 코딩하고 검토 없이 올린 PR을 보고 당황하신 적이 있으실 겁니다. PR마다 로컬에 받아 직접 돌려보고, 문제 없는지 확인할 수 있을까요? 쏟아지는 변경을 사람이 일일이 살펴보는 건 현실적으로 불가능합니다. 즉, 코딩은 빨라졌지만 검증이 병목이 된 것입니다. 간단한 스크립트나 사내 도구라면 일단 배포하고, 문제가 생기면 그때 손봐도 됩니다. 하지만 수십만 명이 쓰는 서비스라면, 걸러지지 않은 결함이 심각한 사업적 타격으로 이어질 수 있습니다. 그렇다고 전부 QA 팀에 떠넘길 수도 없는 노릇입니다. AI가 쓴 코드, 어떻게 검증해야 할까요? AI에게 검증할 수단을 주자 https://medium.com/media/c5f0d8d7e564b7e2b450435729f83521/href Claude Code를 만든 Boris Cherny는 얼마 전 X(트위터)에 ‘Claude에게 자기 작업을 검증할 수단을 줘라. 이건 늘 결과를 2~3배 끌어내는 방법이었다.’ 라고 남겼습니다. 모델에게 검증 수단을 제공하는 것이, 모델이 똑똑해질수록 오히려 더 중요해졌다는 이야기였습니다. 개발자가 자신이 쓴 코드의 결함을 잘 못 찾듯, 모델도 자기가 짠 코드에 대해서는 관대합니다. ‘이 정도면 잘했네’ 하고 작업을 끝내버립니다. 모델에게 검증할 수단을 주기 위해 가장 먼저 떠올린 방법은 에이전트가 직접 브라우저를 조작하게 하는 것이었습니다. Vercel의 Agent Browser, Claude의 Chrome 익스텐션, Playwright MCP 같은 도구들이 이미 나와 있었습니다. 이런 도구를 쥐어주면, AI 에이전트도 사람처럼 화면을 확인하고 브라우저를 직접 조작할 수 있습니다. 덕분에 사람이 매번 직접 확인하던 부담은 확실히 줄었습니다. 문제는 코드를 고칠 때마다 에이전트에게 그 시나리오를 처음부터 다시 시켜야 한다는 점이었습니다. 시나리오를 마크다운에 적어두고 반복하게 할 수는 있었지만, 매번 실행이 오래 걸리고, 토큰도 많이 소모됩니다. 무엇보다 결과가 비결정론적입니다. 필요한 건 에이전트가 언제 돌려도 똑같이 동작하는 결정론적인 테스트 코드였습니다. 🥵 에이전트에게 매번 건네는 테스트 시나리오 1. 대출 비교 페이지(/loan)를 연다 2. 한도조회 버튼을 누른다 3. 한도조회 결과가 보이는지 확인한다 매번 처음부터 다시 실행 → 느리고 토큰을 많이 소모 에이전트가 매번 새로 해석해 조작 → 비결정론적 ✅ 한 번 짜두는 테스트 코드 test('한도조회 버튼을 누르면 결과가 보인다', async ({ page }) => { await page.goto('/loan') await page.getByRole('button', { name: '한도조회' }).click() await expect(page.getByRole('heading', { name: '한도조회 결과' })).toBeVisible() }) LLM 없이 즉시 실행 → 빠르고 토큰
0. 들어가며 안녕하세요. 중고나라 웹개발팀입니다. 현재 중고나라 웹개발팀은 웹 서비스를 리뉴얼하는 과정에서, 기술 스택을 변경하는 큰 규모의 마이그레이션을 진행했습니다. (Next.js Page Router → App Router, React 18 → 19) 리뉴얼을 마치고 출시 전 부하 테스트를 돌렸는데 문제가 터졌습니다. 웹 서버에서 OOM이 발생하는 것입니다. 그래프를 보면 단순한 Memory Peak가 아니었습니다. 메모리가 GC 되지 않고 계속 쌓이는 패턴이었습니다. Memory Leak이 발생해 Pod OOM Killed 확인 (Datadog) 원인을 추적한 결과, Server Component에서 TanStack Query(React Query)의 QueryClient를 클로저가 오랫동안 참조하고 있어 GC되지 못하는 것이 문제였습니다. 이 글에서는 이 메모리 이슈의 원인과 트러블슈팅을 공유하고, 문제의 원인이었던 TanStack Query의 gcTime이 왜 문제가 되었는지 분석한 내용을 설명하고자 합니다. 1. 사전 배경: App Router + TanStack Query SSR 구조 본격적인 트러블슈팅에 앞서, 문제가 발생한 코드를 먼저 짚고 넘어가겠습니다. Next.js App Router에서는 layout과 page가 동일한 요청 스코프 내에서 렌더링됩니다. 이 구조에서 React.cache()로 감싼 QueryClient를 요청 단위로 공유하고, 서버 컴포넌트에서 데이터를 prefetch한 뒤 dehydrate를 통해 클라이언트에 전달하는 패턴을 사용하고 있었습니다. const getQueryClient = React.cache(() => new QueryClient()); React.cache()로 감싼 함수는 동일 요청 내에서 같은 값을 반환하므로, 하나의 요청에서는 하나의 QueryClient가 공유됩니다. 요청이 끝나면 이 QueryClient는 자연스럽게 GC 대상이 되는데, 이 글의 핵심은 바로 이 전제가 깨지는 상황입니다. 전역 layout에서 렌더링되는 GNB 헤더에서, 이 QueryClient를 통해 GNB API를 prefetch하는 구조였습니다. import { dehydrate, HydrationBoundary } from '@tanstack/react-query'; // 서버 컴포넌트 GnbHeader에서 gnb API 응답 캐시 export default async function GnbHeader() { const queryClient = getQueryClient(); await queryClient.prefetchQuery({ queryKey: ["gnb"], staleTime: 1000 * 60 * 30, // 30분 gcTime: 1000 * 60 * 60, // 1시간 queryFn: () => fetchGnb(), }); return ( <HydrationBoundary state={dehydrate(queryClient)}> <HeaderView /> </HydrationBoundary> ); } (fyi. 신규 웹은 TanStack Query v5를 이용하고 있습니다.) GNB는 자주 변하지 않으니 캐시를 오래 유지하겠다는 의도였습니다. 페이지 레벨에서도 동일한 QueryClient를 통해 검색·상품 상세 등의 API를 prefetch했습니다. 즉, 하나의 HTTP 요청 안에서 GNB prefetch, 검색 결과, 상품 상세 등 모든 query 데이터가 하나의 QueryClient 인스턴스에 누적되는 구조였습니다. 정리하면 아래와 같습니다. QueryClient는 React.cache()로 감싸 request scope 내에서 재사용된다. GNB query에 긴 gcTime(1시간)이 설정되어 있다. app/layout.tsx └── Header.tsx (QueryClient 생성 + GNB 캐시 gcTime 1시간) └── page.tsx (동일 QueryClient 재사용, 검색/상품 API 캐시 추가) 기능적으로는 아무 문제가 없었기에, 별다른
지난번 YDS(Yogiyo Design System) v2 컴포넌트 라이브러리 구축기에 이어, 이번 글에서는 YDS v2 컴포넌트 라이브러리와 같은 외부 라이브러리가 서비스 애플리케이션 번들 결과물에 미치는 영향을 살펴봅니다. 또한, 구형 브라우저에 대한 하위 호환성 확보를 위해 요기요 FE 팀이 거친 기술적인 고민과 그 해결 과정들을 공유하고자 합니다. 들어가며 현재 요기요 FE팀은 주요 FE 프로젝트의 기반 프레임워크로 Next.js를 채택하여 사용하고 있습니다. Next.js는 React 기반의 프레임워크로서 웹 개발에 필요한 도구들을 기본적으로 제공합니다. 이러한 편의성 덕분에 개발자는 인프라 설정보다 비즈니스 로직 구현에 더 집중할 수 있는 환경을 갖추게 됩니다. 반면, 라이브러리를 개발하는 과정에서는 다음과 같은 오해에 빠지기 쉽습니다. 오해 1. Next.js가 알아서 Tree-shaking 해줄 것이다. Next.js automatically optimizes bundles by code splitting, tree-shaking, and other techniques. However, there are some cases where you may need to optimize your bundles manually. Next.js는 Code Splitting과 Tree Shaking을 통해 번들 사이즈를 최적화합니다. 이런 특징 때문에 라이브러리 개발자는 사용하지 않는 코드가 빌드 과정에서 알아서 제거될 것이라고 기대하곤 합니다. 하지만 라이브러리가 Tree shaking이 가능한 요건들을 충족하지 못했다면, 프레임워크의 최적화 기능은 무용지물이 됩니다. 라이브러리가 어떤 모듈 시스템(ESM or CJS)으로 배포되는지, Side-Effect를 어떻게 관리하는지, 하나의 파일로 번들링되어 있는지 혹은 모듈 트리구조를 유지하고 있는지에 따라 Next.js는 불필요한 코드를 제거하지 못하고, 결국 사용되지 않는 코드까지 번들에 포함하는 상황이 발생할 수 있습니다. 오해 2. Next.js를 쓰면 구형 브라우저 호환성 문제에서 자유롭다. Next.js 공식문서에 따르면 fetch, URL, Object.assign() 등 자주 사용되는 폴리필이 기본으로 제공됩니다. next-polyfill-nomodule을 통해 다양한 polyfill을 주입하지만, 이는 <script nomodule> 특성상 Chrome 64 미만의 구형 브라우저에서만 로드됩니다. 또한, ESM을 지원하는 브라우저용인 next-polyfill-module은 제한적인 기능만 지원하고 있습니다. 이 때문에 Promise.allSettled()처럼 Chrome 76부터 지원되는 메서드를 사용할 경우, 64~76 버전 사이의 Chrome 브라우저에서는 polyfill을 지원 받지 못하는 사각지대가 발생합니다. 따라서 프로젝트에서 Next.js 기본 제공 범위를 초과하는 API를 사용하고 있다면, 호환성 보장을 위해 개발자가 직접 누락된 폴리필을 확인하고 대응해야 합니다. 요기요 FE에서는 이러한 문제를 해결하기 위해 라이브러리 번들링 전략 개선과 Custom Polyfill 서비스를 구축하였습니다. 자세한 내용은 아래에서 이어서 설명하겠습니다. Tree Shaking을 위한 여정 ESM Tree shaking은 빌드 과정에서 사용되지 않는 코드를 제거하여 최종 번들 크기를 최적화하는 기법입니다. 정적인 import와 export 구문을 분석해 모듈 간의 참조 관계를 파악하고, 실제 실행에 필요 없는 코드를 선별해 삭제합니다. 결국, 코드의 정적 분석이 가능한 ESM을 채택해야만 완전한 Tree Shaking을 구현할 수 있습니다. 따라서 서비스 애플리케이션의 번들 크기를 최적화해 주기 위해서는 라이브러리 차원에서의 ESM 지원이 필수적입니다. Side-Effect 라이브러리를 ESM으로 배포했다고 해서, Tree Shaking이 자동으로 완벽하게 작동하는 것은 아닙니다. Webpack이나 Rollup 같은 번들러는 애플리케이션의 안전한 동작을
들어가며 안녕하세요. 펫프렌즈 프리오더팀 프론트엔드 개발자 박재훈입니다. 저희 프론트엔드 챕터에서는 오랜 시간 해결하지 못한 과제가 있었습니다. 바로 Next.js 서버의 메모리 누수 현상인데요. 펫프렌즈 서비스는 상품 상세 페이지를 시작으로 점진적으로 Vue.js에서 Next.js로 전환해왔으며, 현재는 대부분의 화면이 Next.js 기반으로 동작하고 있습니다. 트래픽이 증가하면서 메모리 사용량이 늘어나는 것은 자연스러운 현상입니다. 하지만 저희가 마주한 상황은 달랐습니다. 메모리 사용량이 시간이 지날수록 계속 증가했고, GC가 제대로 동작하지 않았으며, 결국 서버가 OOM(Out of Memory) 직전까지 메모리를 사용하여 서버를 재실행하는 일이 반복되었습니다. 제목을 보시면 어떤 문제였는지 짐작하셨을 겁니다. 먼저 밝히자면 저희는 Next.js 서버 환경에서 export된 전역 변수로 QueryClient를 생성하였습니다. 이는 명백히 잘못된 패턴이었고, 메모리 누수의 직접적인 원인이었습니다. 이 글에서는 저희가 겪은 메모리 누수 현상의 발견부터 원인 분석, 그리고 해결 과정을 공유하고자 합니다. 이 글은 특정 라이브러리나 프레임워크 자체의 결함을 다루지 않습니다. Next.js와 TanStack Query는 모두 훌륭한 도구이며, 문제의 원인은 공식 문서에서 권장하는 사용 패턴을 따르지 않은 저희의 구현 방식에 있습니다. 이 글을 통해 같은 실수를 반복하지 않길 바라며, 올바른 사용 패턴의 중요성을 함께 나누고자 합니다. 메모리 누수 현상 브라우저 환경에서는 탭을 닫으면 메모리가 해제되고, 사용자가 페이지를 새로고침하면 모든 것이 초기화됩니다. 설령 메모리 누수가 있더라도 사용자 개개인의 브라우저에서 일시적으로 발생하는 문제에 그치는 경우가 많습니다.그러나 SSR(Server-Side Rendering) 환경은 완전히 다릅니다. Next.js 서버는 24시간 365일 동작하며, 수많은 사용자의 요청을 처리합니다. 브라우저처럼 ‘닫으면 끝’이 아닙니다. 한 번 발생한 메모리 누수는 서버가 재시작되기 전까지 계속 누적되며, 이는 모든 사용자에게 영향을 미치는 치명적인 문제로 이어집니다. 펫프렌즈 서비스 Next.js 서버 메모리 사용량 위 그래프를 보시면 문제가 명확하게 파악되실겁니다. 메모리 사용량이 계단식으로 올라가다가 서버를 재시작하는 패턴이 반복되고 있는데요, 정상적인 서버라면 메모리 사용량이 일정 수준에서 유지되거나, GC가 동작하면서 톱니바퀴 모양을 그려야 하는데 저희 서버는 그렇지 않았습니다. 증상은 다음과 같았습니다: 1. 지속적인 메모리 증가 서버 시작 후 시간이 지날수록 메모리 사용량이 선형적으로 증가 Garbage Collection이 실행되어도 메모리가 해제되지 않음 2. 서버 성능 저하 메모리 사용률이 높아질수록 응답 시간 증가 CPU 사용률 증가 (GC가 메모리를 회수하려고 과도하게 시도) 간헐적인 서버 응답 지연 발생 3. 주기적인 서버 재시작 필요 메모리 사용률이 임계치(약 60%)에 도달하면 수동으로 서버 재시작 재시작하지 않으면 OOM으로 인한 서버 크래시 위험 모니터링 부담 가중 무엇보다 사용자가 많아질수록 문제가 더 빨리, 더 심각하게 발생한다는 점이 가장 큰 문제였습니다. 저희는 이 문제를 더 이상 미룰 수 없었고, 근본 원인을 찾아 해결하기로 결심했습니다. Node.js 메모리 구조 메모리 누수 현상에는 다양한 원인이 있을 수 있습니다. 디버깅을 하기 위해서는 어디서부터 시작해야 할까요? 먼저 Node.js의 메모리 구조를 간단히 살펴볼 필요가 있습니다. Node.js 프로세스의 메모리는 크게 다음과 같이 구성됩니다: 대부분의 JavaScript 객체와 데이터는 Heap Memory에 저장됩니다. 왜 Heap Memory부터 확인하는가? 세 가지 이유가 있습니다: 애플리케이션 코드가 직접 관리하는 영역 Stack Memory는 함수가 종료되면 자동으로 해제되고, Native Memory는 Node.js 내부나 네이티브 모듈이 관리합니다. 하지만 Heap은 다릅니다. 저희
 더스윙 기술 블로그
들어가며 안녕하세요. 더스윙에서 iOS 팀장 및 스윙 앱의 iOS 개발을 담당하고 있는 박영수입니다. 앱을 개발하다 보면 다양한 애니메이션 요구사항을 마주하게 되는데요, 애니메이션을 사용하다 보면 의도치 않은 동작을 겪는 경우가 많습니다. 이 글에서는 더스윙에서 애니메이션 관련 이슈를 어떻게 해결했는지 소개하려고 합니다. iOS 개발에서 애니메이션은 필수적인 요소입니다. 최근 앱들은 요소들을 상황에 맞춰 이동시키거나 숨기거나 변형시켜야 할 때가 많습니다. 이럴 때 일반적으로 UIView.animate 함수나 UIViewPropertyAnimator를 사용하게 되는데요, 예상치 못한 문제가 발생하기 마련입니다. 기본적으로 다음과 같은 뷰들이 배치되어 있다고 가정해보겠습니다. menuButton.frame = CGRect(x: 50, y: 250, width: 50, height: 50) menuButton.setTitle("☰", for: .normal) menuButton.setTitleColor(.black, for: .normal) menuButton.backgroundColor = .lightGray menuButton.addTarget(self, action: #selector(menuTapped2), for: .touchUpInside) view.addSubview(menuButton) redBox.backgroundColor = .red redBox.frame = CGRect(x: 50, y: 100, width: 100, height: 100) view.addSubview(redBox) testLabel.frame = CGRect(x: 50, y: 250, width: 300, height: 300) testLabel.text = "Label" testLabel.textColor = .black view.addSubview(testLabel) profileImageView.backgroundColor = .blue profileImageView.layer.cornerRadius = 20 view.addSubview(profileImageView) 여기서 메뉴 버튼을 누르면 화면 배치를 바꾸고, 뷰의 색상과 텍스트 컬러도 변경하려고 합니다. override func viewDidLayoutSubviews() { super.viewDidLayoutSubviews() profileImageView.frame = CGRect( x: isOpen ? view.bounds.width - 60 : 60, y: 50, width: 40, height: 40 ) } @objc func menuTapped() { isOpen = !isOpen UIView.animate(withDuration: 2.0) { self.redBox.frame.size.width = (self.isOpen) ? 300 : 100 self.redBox.backgroundColor = (self.isOpen) ? .yellow : .red self.testLabel.textColor = (self.isOpen) ? .blue : .black self.view.layoutIfNeeded() } } 예시로 든 코드는 극단적이긴 합니다. 일반적으로 프레임을 다시 잡을 때 viewDidLayoutSubviews를 직접 활용하지는 않습니다. 하지만 현재 화면의 bounds 등을 참조해야 할 때나 AutoLayout을 사용한다면 자주 활용되는 방식입니다. 위의 코드를 실행하면 다음과 같은 결과가 나옵니다. 의도치 않게 파란색 뷰가 애니메이션되며, UILabel의 textColor는 점진적으로 바뀌지 않고 순간적으로 변경됩니다. 위의 예시에서는 UIView.animate 함수를 사용했지만, UIViewPropertyAnimator를 사용해도 동일한 결과가 나타납니다. 무엇이 문제인가? CATransaction과 암묵적 애니메이션 이 문제에 대해서 이해하기 위해서는 먼저 UIView.animate 함수의 구동방식에 대해 이해하여야 됩니다. UIView.anim