흩어진 테크 블로그 글을 한곳에서 찾아 읽어요
여러 기술 블로그의 새 글을 제목·요약·태그로 검색하고 주제별·블로그별로 살펴볼 수 있어요. 글 상세와 원문은 로그인 없이 볼 수 있고, 로그인하면 읽음 표시와 즐겨찾기를 동기화하고 개인 노트를 저장할 수 있어요.
기업 기술 블로그별 최신 글 보기 → · 기획자·개발자별 활용 방법 →
여러 기술 블로그의 새 글을 제목·요약·태그로 검색하고 주제별·블로그별로 살펴볼 수 있어요. 글 상세와 원문은 로그인 없이 볼 수 있고, 로그인하면 읽음 표시와 즐겨찾기를 동기화하고 개인 노트를 저장할 수 있어요.
기업 기술 블로그별 최신 글 보기 → · 기획자·개발자별 활용 방법 →
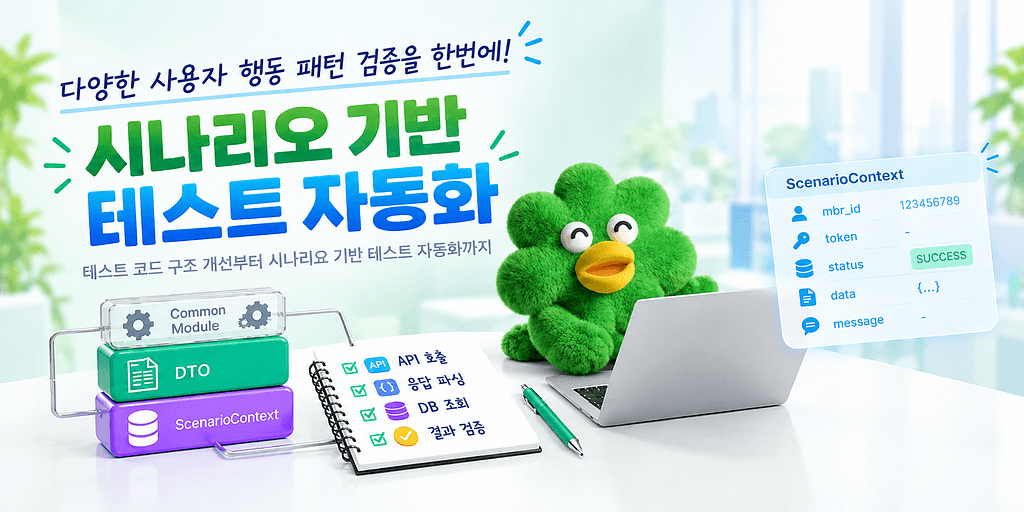
테스트 구조 개선부터 시나리오 기반 테스트 자동화까지 안녕하세요. 회원/주문기획팀 서비스 기획자 김윤겸입니다. 지난 1편에서는 AI를 활용하여 반복적인 수동 테스트를 자동화한 경험을 소개해 드렸습니다. 테스트 데이터를 준비하고 API를 호출한 뒤, 응답 값을 기대 결과와 비교하는 코드를 구현하여 반복 테스트에 소요되는 시간을 획기적으로 단축할 수 있었습니다. AI를 활용한 테스트 자동화 도전기 1편 보러가기 이번 2편에서는 테스트 자동화 확장 과정에서 발생한 한계를 극복하고, 시나리오 기반의 테스트 자동화 과정을 소개해 드리겠습니다. 테스트 자동화를 확장하면서 어떤 한계에 직면하였는가? 초기에는 테스트 케이스가 추가될 때마다 AI의 도움을 받아 필요한 코드를 개별적으로 작성하였습니다. 개별 테스트 코드를 빠르게 구현할 수 있었지만, 유지보수 측면에서 한계가 나타나기 시작하였습니다. ① 코드 중복 : DB 조회, API 호출, 응답 파싱 등 공통 기능 코드 중복 작성 ② 코드 수정 : 공통 로직 변경 시 관련된 여러 파일의 코드 개별 수정 테스트 자동화를 지속적으로 확장하기 위해서는 반복되는 기능을 공통 모듈로 분리하고 재사용할 수 있는 구조로 개선하는 것이 필요하였습니다. 반복되는 기능을 어떻게 공통 모듈로 분리하였는가? 테스트 대상과 검증 조건이 달라도 테스트에서 필요한 기능은 동일하였고, 여러 테스트 코드에서 반복적으로 사용하는 기능들을 정의하고 분류하였습니다. ① 파일 : 테스트 대상자 정보 읽기, 테스트 결과 저장 ② API : API토큰 발급, API 요청, API응답 파싱 ③ DB : 데이터 생성/변경/조회/삭제 ④ 로그 : API요청/응답, SQL Query실행 ⑤ 설정 : DB연결 설정 및 암호화 정보 관리 위와 같이 분류된 공통 기능을 공통 모듈로 분리하고, 각 테스트 코드에서는 필요한 모듈을 Import하여 재사용할 수 있도록 구조를 개선하였습니다. 예를 들어, API 요청·응답 로그를 변경할 때 공통 모듈만 수정하면 해당 기능을 사용하는 모든 테스트 코드에 변경 사항을 일괄 적용할 수 있었습니다. ■ 예시1. API호출 공통화 def call_api(method: str, url: str, **kwargs): logger.info("[API REQUEST] %s %s", method.upper(), url) try: response = httpx.request( method, url, timeout=kwargs.pop("timeout", DEFAULT_TIMEOUT), **kwargs ) return response except httpx.HTTPError as e: logger.error("[ERROR] HTTP : %s", e) return { "status": "500", "message": str(e)[:200], "data": None, } finally: time.sleep(DELAY_SECONDS) 비즈니스 정책 유효성을 어떻게 검증하였는가? 이번 테스트 자동화의 목표는 ‘쓱7클럽 캐시백 정책’이 정상적으로 적용되는지 검증하는 것이었습니다. 캐시백 적립 여부를 정확하게 확인하려면 ‘최초 유료결제일’, ‘유료결제 후 해지 여부’, ‘캐시백 적립 횟수’ 등 다양한 조건 정보를 확인해야 했습니다. ① 유료 결제 후 해지 회원 제외 ② 유료결제월에 따라 캐시백 차등 지급 · ~26년 4월 : 3회 · ~26년 12월 : 2회 · 27년 1월 ~ : 0회(TBD) 초기에는 쓱7클럽 가입 API 응답을 받은 후 정책 검증에 필요한 정보를 개별적으로 조회하였습니다. 여러 데이터를 조합하는 과정에서 검증 코드가 점차 복잡해졌습니다. 이를 개선하기 위해 API 응답 데이터와 DB 조회 결과를 하나의 DTO(Data Transfer Object)로 통합하였습니다. 쓱7클럽 가입 API 호출 후 생성한 DTO를 캐시백 검증 로직에 전달하여, API 응답 데이터와 DB 조회 결과를 별도로 조합하는 과정 없이 쓱7클럽 캐시백 정책 충족 여부를 확인할 수 있었습니다. ■ 예시2. 쓱7클럽 캐시백 정책 검증
안녕하세요. 당근 광고실 광고주플랫폼팀에서 백엔드 엔지니어로 일하는 제이크(Jake)예요. 얼마 전 저희 팀 엔지니어링 매니저 Iltaek이 프론트엔드와 백엔드를 한 팀으로 합친 이야기를 글로 나눴어요. 그 글이 팀의 경계를 넘어 일하는 이야기였다면, 이번 글은 제가 당근 광고 MCP를 만들며 개발자의 역할을 넓혀 본 이야기예요. MCP(Model Context Protocol)는 AI 서비스가 외부 서비스의 데이터를 불러올 때 쓰는 표준 연결 방식이에요. 광고주가 Claude 같은 AI 서비스에 “지난주 광고 성과 어땠어?”라고 물으면, AI가 광고 MCP를 거쳐 당근 광고의 계정 정보와 광고 정보, 성과 데이터를 가져와서 답해 줘요. 해외 광고 플랫폼에서는 구글, 메타, 아마존이 이미 MCP를 공개했고, 국내에서는 당근이 처음으로 공식 광고 MCP를 출시했어요. 저는 개발자로 이 프로젝트에 참여하는 줄 알았는데, 하다 보니 로드맵과 PRD부터 출시까지 맡아야 했어요. 이 글에서는 그 과정에서 겪은 일과, 제가 일하는 방식이 어떻게 달라졌는지 이야기해 보려고 해요. 로드맵과 PRD를 처음 써 봤어요 그동안은 PM과 함께 일하면서 엔지니어로서 개발에 필요한 의견을 나누고, PRD를 어떻게 구현할지 고민했어요. 그런데 이번에는 Iltaek에게 로드맵과 PRD까지 맡아 달라는 요청을 받았어요. 솔직히 요청을 받았을 때는 “이것도 개발자인 내 일인가?” 싶었어요. 로드맵은 PM이 그리는 거 아닌가, 내가 로드맵을 제시하는 게 맞나 하는 생각이 먼저 들었어요. 해 본 적 없는 일이라 부담도 됐고요. 그때 Iltaek이 오너라는 마음가짐으로 해 보라고 했어요. 그 말대로 “내 프로젝트”라고 생각하다 보니, 이 프로젝트를 더 잘되게 하려면 뭘 해야 할지 고민하게 되더라고요. 스스로 던지는 질문부터 달라졌어요. 로드맵을 그리려고 하니, 당근 광고 플랫폼은 생각보다 크고 복잡했어요. 전문가모드, 간편모드, 대행사 플랫폼¹까지 합치면 광고주가 할 수 있는 일이 정말 많아요. 광고 보고서, 광고 수정, 소재 만들기, 타겟팅, 전환 추적, 결제와 충전까지요. 이걸 한 번에 다 MCP로 열 수는 없어서, 범위를 좁혀야 했어요. 혹시나 잘못되더라도 광고주에게 손해가 없는 일인지, 화면보다 AI로 했을 때 더 편한 일인지, 더 많은 광고주에게 도움이 되는 일인지, 이렇게 세 가지 기준을 세워 봤어요. 그래서 리스크가 가장 낮은 조회 기능부터 열었어요. 광고를 수정하는 기능은 충분히 검증한 뒤에 열기로 했어요. AI가 예산이나 입찰가를 바꾸다 실수하면 광고비가 의도와 다르게 나갈 수 있어서요. 결제나 광고 삭제처럼 AI로 하는 게 오히려 불편하거나 위험한 일은 아예 열지 않기로 했어요. 그리고 당근 광고에서 가장 많이 집행되는 디스플레이 광고부터 시작했어요. 그렇게 로드맵을 그리고, 그 안에서 이번에 할 일의 범위를 정했어요. 그다음 저희 팀에서 쓰는 PTBSMAF라는 프레임워크로 PRD를 썼어요. 문제 정의(Problem Statement), 트레이드오프(Trade-off), 벤치마크(Benchmark), 해결책(Solution), 지표(Metrics), 중단 조건(Andon), 피드백 루프(Feedback Loop)의 앞 글자를 딴 이름이에요. 그중에서도 문제 정의, 트레이드오프, 벤치마크가 특히 도움이 됐어요. 문제를 제가 이해한 대로 풀어 쓰다 보니 생각이 정리됐고, 조회만 먼저 열면 무엇을 얻고 무엇을 포기하는지 적으면서 트레이드오프가 분명해졌어요. 특히 벤치마크에서는 다른 광고 플랫폼의 사례를 찾아보면서, 그대로 참고할 부분과 우리 상황에 맞게 바꿔야 할 부분이 구분됐어요. PRD를 쓰면서 이전에는 생각해 보지 못했던 부분까지 고민하게 됐어요. 이 기능으로 플랫폼이 무엇을 얻을지, 어느 제품부터 고려할지, 뭐가 더 나은 방향인지 같은 제품 관점의 고민은 전부 처음이었어요. 이렇게 정한 것들이 정답인지 100% 확신할 수는 없었지만, 적어도 근거를 가지고 정했다는 점은 지금 돌아봐도 만족스러워요. 로드맵은 PM이 그리는 거라고 생각
 케이뱅크 공식 블로그
KBW 2026 참관기 은행의 눈으로 본 블록체인 2026.10.22 이승규 디지털자산TF 케이뱅크에서 이용하시는 디지털자산 서비스에서도 기존 은행의 신뢰를 이어가겠습니다. 요즘 뉴스에서 ‘블록체인’이나 ‘스테이블코인’이라는 단어, 자주 보셨죠? 몇 년 전만 해도 코인 투자자들 사이의 이야기였는데, 이제는 은행과 정부, 국회가 함께 다루는 주제가 됐어요. 이런 디지털자산에 관한 흐름을 가장 가까이에서 볼 수 있는 행사는 바로 코리아블록체인위크(KBW)인데요! 지난 9월 말 저도 다녀왔습니다. 제가 느끼기에 올해 KBW는 ‘크립토 행사’라기보다 ‘금융 행사’에 더 가까웠어요. 은행의 시각으로 바라 본 KBW가 어떤 행사인지, 그리고 그 동안 디지털자산 관련 케이뱅크가 걸어온 길까지 함께 담아 정리해 보겠습니다. KBW, 어떤 행사일까요? 올해로 어느새 9회째인 KBW(Korea Blockchain Week)는 팩트블록이 주최하는 국내 최대 규모의 블록체인 컨퍼런스입니다. 블록체인 관련 행사는 Web3 기업들이 많이 참석하기 때문에 보통 복장이 자유로운 편인데요. 이번 행사는 예년보다 정장 차림이 많다는 이야기가 곳곳에서 들렸고, 정해진 드레스코드랄게 없었는데도 연사뿐 아니라 참석자 중에도 정장을 입은 분들이 꽤 많았어요. 재미있게도, 올해 KBW가 ‘금융 행사’에 가까웠다는 걸 가장 먼저 체감할 수 있는 부분이었습니다. 2026년, 금융권은 왜 KBW에 주목했을까요? 한마디로 정리하면, 디지털자산이 ‘투자 대상’에서 ‘금융 인프라’로 넘어오고 있기 때문일 겁니다. 행사 내 다양한 세션에 참여하며 얻은 인사이트를 세 가지로 정리해 봤습니다. 행사가 기관 중심으로 변경 — 전체 연사 290명 가운데 115명(39.7%)이 금융·정책·투자 분야 관계자였습니다. 올해 새로 생긴 기관 파트너에는 한국투자증권, 삼성증권, 교보생명, 현대카드 등 증권·보험·카드 업권이 고루 이름을 올렸어요. 국내 제도화가 코앞 — 원화 스테이블코인을 제도권으로 들이는 디지털자산기본법이 하반기 입법 과제로 올라와 있습니다. 자연스럽게 정책과 법안, 그리고 금융 현장에서의 활용을 다루는 세션이 많았어요. 논의의 방향이 실질적인 ‘활용’으로 이동 — 리플의 모니카 롱 사장은 앞으로 5년 안에 토큰화된 실물자산을 24시간 거래하고 담보로 쓰는 일이 늘어날 거라고 내다봤어요. SBI그룹은 토큰화를 실증에서 실제 도입으로 넓힌 경험을 나눴고, 전시장에서는 NHN KCP가 원화 스테이블코인으로 결제부터 가맹점 정산까지 이어지는 흐름을 직접 시연했습니다. 이제 화두는 “블록체인에는 어떤 기술들이 있는가?”가 아니라 “금융에서 구체적으로 어떻게 활용할 수 있을까?”로 바뀌었습니다. 저희가 매일 붙잡고 있는 고민이기도 해요. 법이 어떻게 제정되든, 은행은 지금 할 수 있는 서비스를 찾아 고객에게 전해야 하니까요. 케이뱅크도 무대에 섰어요! KBW 기간에는 메인 컨퍼런스 외에도 서울 곳곳에서 다양한 행사가 함께 열리는데요. 올해 케이뱅크는 그중 금융기관과 기관 투자자가 모이는 두 행사에 패널로 참여했습니다. 디지털자산TF를 맡고 있는 최재혁님이 직접 무대에 올라, 케이뱅크가 준비해 온 스테이블코인 해외송금 이야기를 전했어요. ① 브릿지 서울 2026 — 은행에 ‘게이트웨이’ 역할이 더해진다 일정 — 10월 1일(목), 서울 글래드 호텔 여의도 주최 — 웨이브릿지 (기관02 대상 초청제 컨퍼런스) 세션 — ‘Session 2 · Payments & Settlement’ — 스테이블코인 결제와 정산 패널 — 케이뱅크·BC카드·카카오뱅크 (진행: 웨이브릿지 부대표) 브릿지 서울 2026 ‘Session 2 · Payments & Settlement’ 패널 토론 현장 브릿지 서울은 금융기관과 기관 투자자를 대상으로 한 초청제 컨퍼런스예요. 최재혁 님이 참여한 패널 대담에서는 카드사와 인터넷은행이 스테이블코인 결제를 어떻게 준비하고 있는지, 그리고 그 과정에서 은행의 역할이 어떻게 달라질지를 이야기했어요. 최재혁 님은 앞으로 은행에 ‘게이트웨이’ 역할이 더해질 것이라고 봤
글. 박수봉(Henby) / 서비스웹개발팀 안녕하세요. 서비스웹개발팀 헨비입니다. 9월 7일, 여기어때 해외투어 서비스를 오픈했습니다. 프론트엔드 담당 개발자는 두 명이었고, 웹과 앱 웹뷰를 하나의 코드베이스로 개발했습니다. 저는 웹 카테고리홈·상품 상세·주문서·예약내역·해외투어용 채팅을 맡았고, 검색바·헤더·푸터·예약내역 탭·찜 탭·회원탈퇴처럼 여러 서비스가 함께 쓰는 공통 화면도 담당했습니다. 3월 13일에 빈 앱을 만들고 9월 7일에 오픈까지 총 25주였습니다. 이 글은 그 25주 동안 어떤 것을 만들었고 어떤 판단을 했는지 정리한 기록입니다. 세 번의 신규 서비스, 개발 범위는 넓어지고 처리는 빨라졌습니다 여기어때에서 신규 서비스 프론트를 맡은 건 이번이 세 번째입니다. 2024년 가을 해외숙소 비회원 예약, 2025년 봄 패키지여행, 그리고 이번 해외투어까지입니다. 세 프로젝트를 같은 기준으로 비교해 보니 한 가지 흐름이 보였습니다. 저의 담당 범위는 점점 넓어지고 깊어졌습니다. 첫 번째 프로젝트에서는 주문서·예약완료·예약내역·조회 흐름을, 두 번째에서는 웹 PDP·홈 검색·채팅을 맡았습니다. 이번에는 웹과 앱을 합쳐 여덟 개 영역을 담당했고, 웹과 웹뷰를 동시에 개발했습니다. 반면 작업해야 할 레포 수는 줄었습니다. 첫 번째 프로젝트에서는 세 개, 두 번째에서는 두 개의 레포를 오갔지만, 이번에는 모노레포 하나와 채팅 레포 하나로 작업했습니다. QA 티켓은 77건, 55건, 280건으로 늘었지만 3일 내 처리율은 48%, 62%, 81%로 높아졌습니다. 범위와 티켓 수는 늘었지만 처리 속도는 빨라졌습니다. 그 변화를 만든 작업을 정리해 봤습니다. 모노레포에서 두 번째 서비스를 올렸습니다 해외투어는 모노레포에 올라간 두 번째 서비스였습니다. 첫 번째 서비스인 항공팀은 웹·모바일웹·웹뷰를 하나의 코드베이스로 운영할 기반을 이미 만들어 둔 상태였습니다. 구축 과정은 같은 팀 에릭이 쓴 “항공 프론트엔드 구축기” 열 편에 자세히 정리돼 있습니다. [링크] 저는 그 기반을 활용했습니다. 웹 레이아웃의 Provider 스택은 항공 레이아웃을 따라 3월 말에 구성했습니다. 현재 구조는 다음과 같습니다. <PlatformProvider value={{ platform: 'web', isWebAccess: true }}> <AppInitializer runtimeEnv={process.env.NEXT_PUBLIC_ENV} /> <AuthProvider initialUser={user}> <GtmTrackingProvider> <LoadingSpinnerProvider> <DialogProvider> <SnackbarProvider>{children}</SnackbarProvider> </DialogProvider> </LoadingSpinnerProvider> </GtmTrackingProvider> </AuthProvider> </PlatformProvider> 플랫폼 판정, 앱 초기화, 인증, 계측, 로딩, 다이얼로그, 스낵바의 순서는 항공과 같습니다. 앱 레이아웃은 첫 줄의 platform 값만 다릅니다. 앱과 웹의 로그인 분기, 브라우저 뒤로가기와 안드로이드 백키를 함께 처리하는 모달 구조, 팀 공통 디자인 시스템 YDS도 그대로 활용했습니다. 개발자 두 명이 화면 서른일곱 개를 만들어야 하는 상황에서 기반을 새로 만들기보다, 먼저 개발중인 항공에서 이미 검증한 구조를 재사용하는 편이 합리적이었습니다. 대신 서비스에만 필요한 구현으로 남지 않도록, 재사용 가능한 기능은 공유 패키지에 추가했습니다. 25주 동안 공유 패키지에 182건을 커밋했고 컴포넌트 파일 50개를 새로 만들었습니다. 이미지 전체 보기 모달을 공통화하고, 결제수단 UI를 패키지로 분리했으며, 화면에 묶여 있던 찜 API는 앱 공용으로 옮겼습니다. 공유 패키지를 수정하면 항공에 영향을 줄 수 있습니다. 그래서 서비스 브랜치는 master에서만 분기하고, 공유 패키지 변경은 서비스 브랜치 안에서 격리한 뒤 master 머지를 통해서만 다른 서비스에
글. 박동규(jiha) / 광고플랫폼개발팀 안녕하세요. 여기어때컴퍼니 광고플랫폼개발팀 지하입니다. 저희 팀은 설치형 ERD 솔루션으로 ERD를 설계하고 관리해 왔습니다. 쓰는 사람마다 프로그램을 설치해야 했고, 라이선스 비용도 들었습니다. 무엇보다 테이블을 하나하나 그리고 관계를 잇는 일을 전부 사람이 했습니다. 그래서 올해 초부터 AI로 ERD를 그릴 수 없을까 고민했습니다. 처음에는 AI에게 그려 달라고 하면 끝날 줄 알았습니다. 몇 번 시켜 보고 나서야, 매번 같아야 하는 일을, 시킬 때마다 답이 달라지는 비결정적인 AI에게 통째로 맡긴 게 문제라는 걸 알았습니다. 그래서 생각을 바꿨습니다. AI가 직접 그리지 않고, 도구를 써서 그리게 하기로요. 아래에는 그렇게 AI에게 줄 도구를 만들면서 부딪힌 문제와, AI가 도구를 헷갈리지 않고 쓰게 하려고 정한 설계 원칙을 정리했습니다. AI에게 그냥 그려 보라고 했더니 처음에는 아무 도구 없이 AI에게 그려 달라고 했습니다. Mermaid로 그리게도 해 보고, HTML로 그리게도 해 봤습니다. 생각처럼 되지 않았습니다. 배치가 원하는 방향으로 나오지 않았고, 제대로 그려지지 않을 때도 많았습니다. 팀의 규칙을 지키지 못하는 경우도 잦았습니다. 무엇보다 같은 걸 시켜도 시키는 사람마다 다른 결과가 나왔습니다. 틀린 곳을 매번 다시 바로잡다 보니 피로가 쌓였습니다. AI의 답은 비결정적입니다. 같은 요청에도 매번 다르게 답할 수 있습니다. 그렇다면 매번 같아야 하는 일까지 AI에게 맡기지 말고, 매번 같은 결과를 내는 도구를 AI에게 쥐여 주면 되지 않을까 싶었습니다. 누가 시켜도 같은 ERD가 나오게 하는 것, 이것이 처음 세운 목표였습니다. 설계는 AI가, 그림은 도구가 처음부터 지금 모양은 아니었습니다. 가장 중요하게 생각한 건 “AI가 ERD를 대신 그려 주는 것”이었고, 처음에는 편집기 안에 채팅 창을 넣고 API 키로 AI를 붙이려고 했습니다. 그런데 준비하는 사이에 AI 서비스의 정책이 바뀌었습니다. 구독 계정을 다른 도구 안에서 쓰는 길이 막혀서, 편집기 안에서 AI를 쓰려면 구독과 별도로 쓰는 만큼 API 요금을 내야 했습니다. 한참 고민한 끝에 방향을 뒤집었습니다. AI를 도구 안에 넣는 대신, 도구를 AI에게 주기로 했습니다. 그러면서 역할도 나눴습니다. AI는 사용자와 대화하며 ERD를 설계합니다. 어떤 테이블이 필요하고 무엇을 어떻게 이을지 함께 고민합니다. 그렇게 정한 내용을 도구에 그려 달라고 요청하면, 실제로 그리는 일은 도구가 합니다. 대화는 이미 쓰고 있는 AI 클라이언트에서 하고, 제가 만든 ERD 도구는 MCP(Model Context Protocol)로 ERD를 그리는 기능을 AI에게 제공합니다. 같은 설계, 세 가지 그림 도구를 쓰면 그림이 얼마나 달라지는지 직접 비교해 봤습니다. AI가 설계한 가상 쇼핑몰 ERD 하나를 준비했습니다. 회원, 상품, 주문, 결제, 배송, 쿠폰, 리뷰 같은 테이블 20개와 관계 27개입니다. 이 설계는 그대로 두고, 그리는 방법만 바꿔 Mermaid와 HTML, 그리고 직접 만든 ERD 도구로 그렸습니다. [그림 1–1] Mermaid로 그린 결과 Mermaid는 테이블을 어디에 놓을지 스스로 정합니다. 테이블이 20개가 되자 그림이 가로로 길게 퍼졌고, 관계선은 멀리 돌아 다른 테이블 사이를 가로질렀습니다. 배치가 마음에 들지 않아도 손댈 방법이 없습니다. 표현에도 한계가 있었습니다. 타입에 공백을 쓸 수 없어 BIGINT UNSIGNED가 BIGINT_UNSIGNED로 바뀌었고, NULL 여부와 한글 이름은 설명 칸에 몰아 적어야 했습니다. [그림 1–2] HTML로 그린 결과 HTML은 표 모양을 원하는 대로 꾸밀 수 있습니다. 대신 테이블을 어디에 둘지, 선을 어떻게 이을지를 코드로 직접 정해야 합니다. 목록 순서대로 격자에 놓았더니 관계선이 서로 엇갈리고 카드 뒤로 지나가서, 어느 테이블과 이어지는지 따라가기 어려웠습니다. 읽을 만하게 만들려면 자리와 선을 손으로 다시 짜야 하고, 설계가
WORXPHERE 통합 서버에서 하이브리드 아키텍처로의 진화 [Batch Runner] 들어가며 잡코리아 메인 페이지에서는 다양한 형태의 CPT(Cost Per Time) 상품을 제공하고 있습니다. 주문 상품, 테마관, 슈퍼기업관 등 각기 다른 특성을 가진 상품들이 사용자에게 노출되는데요. 이러한 상품들의 데이터를 조회하고 HTML 데이터를 생성하는 작업은 초기에 Windows 스케줄러를 통해 5분마다 배치 API를 호출하고, 같은 서버에서 사용자 서비스도 함께 제공하는 방식으로 구현되어 있었습니다. 하지만 서비스가 성장하면서 개선이 필요한 부분들이 명확해졌습니다. 매번 전체 데이터를 조회하는 Full Scan의 부담, 서비스 서버와 배치 서버의 분리 필요성, 트래픽 증가에 대한 탄력적 대응의 어려움 등이었습니다. 이 글에서는 초기 배치 시스템을 개선하고, Event-Driven + Scheduled Batch 하이브리드 아키텍처로 어떻게 진화시켰는지, 그 과정에서의 의사결정과 구현 방식을 소개하겠습니다. 개선이 필요했던 이유 초기 구조 초기 구조는 API 서버와 배치 처리가 하나로 통합된 서버에서, Windows 스케줄러를 통해 5분마다 배치 API를 호출하여 모든 CPT 상품 데이터를 Full Scan으로 조회하고 HTML 데이터를 생성하는 방식이었습니다. [Windows 스케줄러] → (5분마다) → [통합 서버] ├─ 배치 API 호출 ├─ Full Scan 데이터 조회 ├─ HTML 데이터 생성 └─ 사용자 요청 처리 초기 구조의 강점 구현이 단순함: 매번 전체 데이터를 조회하기 때문에 실패해도 다시 실행하면 됨 데이터 정합성: 항상 최신 상태의 전체 데이터를 기준으로 처리 빠른 출시: 단순한 구조로 초기 서비스를 빠르게 런칭할 수 있었음 개선이 필요했던 포인트 서비스가 성장하면서 다음과 같은 개선 포인트가 명확해졌습니다. 비효율적인 조회 방식: 변경되지 않은 데이터까지 매번 Full Scan으로 조회하여 불필요한 DB 부하가 발생했습니다 서버 역할 분리 필요: 배치 처리 서버와 사용자 서비스 서버가 같은 서버이다 보니, 배치 장애 발생 시 서비스 전체에 영향을 줄 수 있었습니다 탄력적 확장의 어려움: 트래픽 증가 시 배치 처리와 서비스 처리를 독립적으로 스케일링하기 어려웠습니다 배치 윈도우 초과: 주문이 몰리는 날에는 5분 배치 주기 내에 데이터 처리를 완료하기 어려워 지연이 누적되었습니다 전환의 계기 서비스가 성장하면서 배치 처리와 사용자 서비스의 분리 필요성이 더욱 명확해졌습니다. 또한 주문이 많은 날에는 주문 데이터를 빠르게 처리해야 한다는 요구사항이 강해졌습니다. 기존 Full Scan 방식으로는 지연이 발생해 처리가 어려웠습니다. 새로운 아키텍처 설계 요구사항 문제를 해결하기 위해 새로운 아키텍처가 갖춰야 할 요구사항을 정리했습니다. 서비스 독립성 : 배치 서버 장애가 사용자 서비스에 영향을 주지 않아야 함 탄력적 확장 : 트래픽 증가 시 API 서버만 스케일 아웃 가능해야 함 실시간 반영 : 주문 상품은 결제 즉시 메인에 노출되어야 함 효율적인 조회 : 전체 데이터가 아닌 변경된 데이터만 조회해야 함 데이터 유실 방지 : 서버 장애 시에도 처리할 데이터가 유실되지 않아야 함 중복 방지 : 동일한 데이터가 중복 처리되어서는 안 됨 변경된 아키텍처 새로운 구조는 배치 서버, Data Express, Display API 서버로 역할을 분리하고, 주문 상품은 Kafka Event로 실시간 처리하며, 테마관/슈퍼기업관은 스케줄 기반으로 Full/Incremental 처리하는 방식으로 설계되었습니다. 새로 변경된 아키텍처 BatchRunner 모든 배치를 동일한 방식으로 처리할 필요는 없다. 상품 특성에 맞는 최적의 처리 방식을 선택하자. 왜 하이브리드 구조인가? 모든 상품을 동일한 방식으로 처리하지 않고, 상품 특성에 따라 서로 다른 처리 방식을 선택한 이유는 명확합니다. 주문 상품 → Event-Driven (Kafka) 주문 상품은 사용자가 결제하는 순간 주문 이벤트가 발생하므로, 이를 즉시 처리
주요소식 The Story of VS Code Visual Studio Code 공식 채널이 공개한 약 1시간 38분 분량의 다큐멘터리로, Erich Gamma가 이끈 취리히 팀이 브라우저용 편집기 컴포넌트 Monaco Editor를 만들던 시기부터 데스크톱 VS Code 발표와 오픈 소스 전환까지의 과정을 30여 명의 관계자 인터뷰로 보여 준다. 확장을 별도 프로세스에서 실행하고 한번 공개한 API는 바꾸지 않는 원칙, TypeScript 서버에서 출발한 LSP, UI와 확장 호스트를 분리한 구조가 원격 개발과 vscode.dev로 이어진 배경을 설명한다. 후반부에서는 GitHub Copilot의 출발과 Ask, Edits, Agent Mode로 이어진 AI 기능, Cursor 같은 포크를 바라보는 VS Code 팀의 시각도 소개한다. Native is now the future of mobile at Shopify 2020년 React Native 전면 도입을 선언했던 Shopify가 모바일 앱을 다시 Swift와 Kotlin 네이티브로 옮긴다고 발표했다. 코딩 에이전트 덕분에 두 플랫폼에 각각 구현하는 비용이 줄면서 공유 구현보다 네이티브의 이점이 커졌다는 판단으로, Shop 앱은 12주 만에 재구축했고 화면을 작은 체크포인트로 나눠 테스트, 시각 비교, 적대적 코드 리뷰, 사람의 승인을 거치게 하는 Helix 시스템을 만들었다. React Native Skia, FlashList, Restyle 등 Shopify가 관리해 온 오픈소스의 향후 계획도 공개해, 이 라이브러리를 쓰는 프로젝트라면 전환 일정을 확인해 둬야 한다. 토스 FE 개발자들의 검증법 토스 웨비나에서 Front AI 팀이 AI로 만든 결과물을 검증하는 방법을 소개한 세션이다. 코드에서 시나리오를 추론해 E2E 테스트를 자동 생성하려던 시도가 실패한 뒤, 얼굴 인식 결제처럼 실수 비용이 큰 영역에서 테스트를 직접 작성하며 디바이스 팜 조작 도구, 액션 로그 조회 스킬처럼 테스트를 막던 요소를 해결하는 도구를 만들어 온 과정을 설명한다. 사람이 CI 실패 원인을 파악하도록 만든 replay 도구를 에이전트에 그대로 넘기자 버튼 문구 변경 같은 실패를 스스로 고쳤다는 경험은 AI 검증 체계를 고민하는 FE 팀이 참고할 만하다. penpot 브라우저에서 쓰거나 직접 설치해 운영할 수 있는 오픈소스 디자인, 프로토타이핑 플랫폼이다. 디자인을 SVG, CSS, HTML 같은 개방형 표준으로 표현하고 CSS Grid와 Flex 레이아웃, 디자인 토큰, 컴포넌트를 기본 기능으로 제공하며, MCP 서버를 통해 Cursor나 Claude Code 같은 AI 에이전트가 컴포넌트, 토큰, 레이어 구조를 읽고 수정할 수 있다. 셀프 호스팅이 가능해 디자인 데이터를 사내에 두어야 하는 조직이 검토해 볼 만한 MPL-2.0 라이선스 프로젝트다. Full Course: Spec-Driven Development with Coding Agents DeepLearning.AI와 JetBrains가 만든 명세 주도 개발(Spec-Driven Development) 강좌의 전체 영상으로, 마크다운 명세를 먼저 쓰고 코딩 에이전트가 이를 구현하게 하는 흐름을 WebStorm과 Claude Code로 Next.js 예제 앱을 만들며 보여 준다. mission.md, techstack.md, roadmap.md로 프로젝트 헌장을 만든 뒤 기능마다 명세를 작성하고 컨텍스트를 비운 상태에서 구현을 맡기는 반복 과정을 설명한다. 기존 코드베이스에서 헌장을 역으로 만드는 방법과 Spec Kit, OpenSpec 같은 공개 SDD 도구도 소개해, 코딩 에이전트 결과물의 일관성을 고민하는 개발자에게 도움이 된다. >> FE News 26년 10월 소식 보러가기 ◎ FE News란? 네이버 FE 엔지니어들이 엄선한 양질의 FE 및 주요한 기술 소식들을 큐레이션해 공유하는 것을 목표로 하며, 이를 통해 국내 개발자들에게 지식 공유에 대한 가치 인식과 성장에 도움
하루 걸리던 회귀 테스트를 30분으로 만든 이야기 무신사 Retail Platform QA팀이 Playwright와 Slack 봇, AI 기반 TC 생성기를 만들어 온 기록 들어가며 안녕하세요. 무신사 PBO(Platform Business Operation)에서 Retail Platform QA 엔지니어 고남석입니다. Retail Platform팀은 편집샵과 무탠다드, 29CM 같은 오프라인 매장을 운영하는 플랫폼을 개발합니다. mPOS, Self-POS, PDP, MOSS까지 여러 서비스가 촘촘히 맞물려 돌아가는 구조입니다. QA팀은 매주 정기 배포를 합니다. 문제는 배포마다 반복되는 회귀 테스트였습니다. 새 프로젝트를 병행하면서 수동 회귀까지 감당하기에는 인원이 부족했고, 도메인은 계속 늘었습니다. 그때 정기 배포 회귀 테스트는 하루 꼬박 걸렸습니다. 이 글은 그 문제를 풀려고 만든 자동화 이야기입니다. UI 자동화에서 시작해 Slack 봇과 AI 기반 테스트케이스 생성기까지 만들었습니다. 커버리지가 다 찬 상태는 아니지만, 지금 자동화된 범위에서는 회귀 테스트가 30분에 끝납니다. 01. 전체구조 프로젝트는 크게 다섯 영역으로 구성됩니다. 테스트 실행 자동화(UI)만 만드는 것이 아니라 기획 → 설계 → 실행 → 리포트까지 하나의 파이프라인으로 잇는 것이 목표였습니다. 02. 왜 Playwright인가 UI 자동화 도구는 Selenium과 Cypress, Playwright를 놓고 비교한 끝에 Playwright와 TypeScript를 골랐습니다. Selenium은 오래된 레거시가 많고 설정이 복잡합니다. Cypress는 JavaScript 생태계와 잘 맞지만 멀티 탭과 도메인 처리에 제약이 있습니다. Playwright를 고른 이유는 세 가지입니다. ① Auto-wait 요소가 나타날 때까지 자동으로 기다리기 때문에 sleep()이나 wait() 같은 수동 대기 코드가 거의 필요 없습니다. 매장 POS 특성상 결제 처리나 재고 조회 같은 API 응답이 느릴 수 있는데, Playwright는 이를 자연스럽게 처리합니다. ② 네트워크 인터셉트 API 요청을 가로채서 원하는 응답으로 교체할 수 있어 특정 엣지케이스(재고 없음, 결제 실패 등)를 외부 서버 세팅 없이 재현할 수 있습니다. ③ Trace Viewer 테스트가 실패하면 각 스텝의 스크린샷과 DOM 상태, 네트워크 로그를 타임라인으로 재생할 수 있어 원인 분석이 빠릅니다. 03. E2E 테스트 설계 Page Object Model로 유지보수 비용 낮추기 테스트 코드에서 가장 큰 문제는 UI가 바뀔 때마다 테스트가 깨지는 것입니다. 이를 해결하기 위해 Page Object Model(POM) 패턴을 적용했습니다. 핵심 아이디어는 UI 조작 로직을 테스트 로직에서 분리하는 것입니다. 버튼 클릭·입력·요소 탐색 같은 UI 조작은 Page 클래스가 담당하고, 테스트 코드는 “무엇을 검증하는가”에만 집중합니다. 이 구조 덕분에 UI 변경이 생겨도 해당 Page 클래스 하나만 수정하면 됩니다. 테스트 코드는 건드릴 필요가 없습니다. 스모크 vs 회귀 분리 전략과 현재 커버리지 모든 테스트를 매번 돌리면 너무 느립니다. 목적에 따라 스모크와 회귀를 분리했습니다. 스모크 테스트: “서비스가 죽지 않았는가”를 빠르게 확인. 핵심 결제 흐름처럼 반드시 동작해야 하는 시나리오만 포함. 배포 직후 또는 평일 2회 자동 실행. 회귀 테스트: “알려진 기능이 여전히 동작하는가”를 확인. 정기 배포 전에 실행하며 엣지케이스와 다양한 결제 수단까지 커버. 지금까지 41개 파일, 234개 테스트 케이스를 자동화했습니다. mPOS가 가장 복잡한 도메인이라 결제 수단별(카드, 현금, 간편PAY)과 회원 유형별로 시나리오를 나눠 뒀습니다. Okta 인증: 로그인 세션을 워커 단위로 공유 mPOS는 Okta 인증이 필요합니다. 그냥 구현하면 테스트마다 로그인을 반복하고 전체 실행 시간이 늘어납니다. Playwright는 테스트를 워커 단위로 병렬 실행합니다. worker-scoped fi
기획자의 API 테스트 자동화로 업무 효율 높이기 안녕하세요. 회원/CS기획팀 서비스 기획자 김윤겸입니다. 요즘 ‘바이브코딩’이 유행하고 있습니다. 내가 무엇을 원하는지 AI에게 설명하면 AI가 코드를 작성해주고, AI와 대화하면서 원하는 결과물을 만들어갈 수 있게 되었습니다. 바이브코딩의 확산과 함께 기획자와 개발자의 경계가 점점 허물어지면서 ‘기발자(기획자+개발자)’라는 신조어까지 등장할 만큼 개발에 대한 접근성도 높아졌습니다. 서비스 기획자로서 ‘바이브코딩’으로 무엇을 해보면 좋을지 생각해보았습니다. 동일한 테스트를 반복해서 하고 있는데, 이 테스트를 자동화할 수 있지 않을까? 이 작은 궁금증을 시작으로 AI를 활용한 테스트 자동화에 도전해보기로 했습니다. 동일한 테스트를 계속 반복해야 할까? 서비스를 테스트하다 보면 동일하거나 유사한 테스트를 반복해야 하는 순간이 찾아옵니다. 최근 SSG 멤버십이 ‘유니버스클럽(신세계그룹 통합 멤버십)’ 연 멤버십에서 ‘쓱7클럽(SSG전용 멤버십)’ 월 멤버십으로 개편되면서 가입일자별 월 결제일과 이용기간을 정확히 검증해야 했습니다. 예를 들면, 1월 29, 30, 31일 가입자는 2월에 동일한 날짜가 없기 때문에 2월 28일에 정기결제가 진행되어야 하고, 3월부터는 다시 가입일자인 29, 30, 31일을 기준으로 이용기간이 계산되어야 했습니다. (이미지1) 멤버십 이용기간 정책 1월 29일 가입자 데이터 하나를 검증하기 위해 거쳐야 하는 단계는 다음과 같습니다. ① 1월 29일 멤버십 가입 → 이용기간 정상 여부 확인 ② 2월 28일 멤버십 정기결제 → 이용기간 정상 여부 확인 ③ 3월 29일 멤버십 정기결제 → 이용기간 정상 여부 확인 문제는 가입일자별로 ‘테스트 데이터 정의 → API 수동 호출 → 테스트 결과 수동 확인’ 과정을 계속 반복해야 했습니다. 테스트 중 이용기간 계산 로직에 문제가 발견되면 수정한 후 다시 테스트해야 했습니다. 이 과정을 자동화하면 업무 효율을 높일 수 있겠다는 생각이 들었고, 테스트 자동화의 첫 번째 과제로 선정했습니다. 테스트 자동화를 어떻게 시작해야 할까? 초보자도 쉽게 접할 수 있는 프로그래밍 언어 중 하나인 Python을 선택했습니다. PC에 Python을 설치하고, 내가 원하는 테스트 흐름을 코드로 대신할 수 있는지 확인하기 위해 먼저 테스트 자동화 절차부터 정리했습니다. ① 테스트 검증 데이터 생성 ② 멤버십 가입API 호출 ③ 멤버십 가입 API 응답 값(멤버십시작일, 멤버십종료일) 확인 ④ 테스트 검증 데이터와 멤버십 가입 API응답 값 비교 테스트 자동화 절차를 정리한 후, Python을 통해 각 단계를 하나씩 코드로 구현할 수 있는지 확인해보기로 했습니다. (이미지2) 테스트 검증 데이터 코딩을 몰라도 테스트 자동화를 할 수 있을까? ChatGPT와 Gemini 같은 생성형 AI를 활용한다면 충분히 가능합니다. 처음에는 Python 코드 작성이 익숙하지 않았지만, 각 단계별로 AI에게 질문하고 답변받은 코드를 직접 실행하면서 테스트 자동화 코드를 완성해나갈 수 있었습니다. ① csv파일 읽기 df = pd.read_csv( file_path, dtype=dtype, encoding="utf-8-sig" ) ② API 호출하기 payload = { "mbrspItemId": row["mbrsp_item_id"], "mbrspJoinDt": row["mbrsp_paymt_expc_dt"] } response = httpx.post( API_URL, headers=HEADER, json=payload, timeout=TIMEOUT ) ③ API응답 값 파싱하기 data = response.json().get("data") ④ 결과 값 비교하기 exp_strt_dt = row["mbrsp_strt_dt"] exp_end_dt = row["mbrsp_end_dt"] act_strt_dt = data["mbrsp_strt_dt"] act_end_dt = data["mbrsp_end_dt"] assert exp_strt_dt ==
표준 위에 얹는 시맨틱 레이어 사람과 여러 AI가 같은 코드를 다루는 시대에, ‘우리 조직만의 도메인 지식’을 모든 에이전트가 함께 읽게 만드는 법. 표준 기반 Core와 조직 특화 Overlay로 이뤄진 2층 시맨틱 레이어를 만들고, 그게 언제 통하고 언제 위험한지 150개 질문으로 비교해본 이야기. 자신만만하게 틀리는 AI 낯선 레거시 코드 한 조각을 AI에게 던져본 적 있으신가요. “이 엔티티, 업무적으로 뭐야?” 돌아온 답은 대개 이렇습니다. 큰 틀은 맞고, 우리 조직 이야기로 들어가면 무너집니다. “재고를 관리하는 도메인이군요.” 여기까진 잘합니다. 그 도메인의 산업 표준을 이미 학습했으니까요. “이 상태값은 이럴 때 이렇게 넘어갑니다.” 우리 조직만의 규칙에 들어서는 순간 자신만만하게 틀린 답이 나옵니다. 많은 산업 도메인에는 전 세계적으로 표준화된 비즈니스 모델이 있습니다. 물류와 회계, 결제, 제조에는 국제 표준이 잘 정의돼 있고 LLM은 그 표준을 압니다. 문제는 실제 회사 시스템이 “표준 모델 + 그 위에 얹힌 우리만의 특수 프로세스”라는 데 있습니다. AI가 아는 건 앞의 절반뿐입니다. 이 글은 그 나머지 절반을 AI에게 이해시킨 이야기입니다. 그게 언제 도움이 되고 언제 오히려 독이 되는지 점검한 기록이기도 합니다. 혼자 챗봇에 묻던 시절이라면 개인 팁으로 끝났을 겁니다. 지금은 코드 리뷰 봇, 운영 지원 에이전트, IDE 코파일럿까지 여러 AI가 사람과 나란히 같은 코드를 만집니다. AI가 하나면 사수가 옆에서 알려주면 됩니다. 여럿이면 각자에게 도메인을 따로 가르치는 방식으로는 감당이 안 됩니다. 모두가 함께 읽는 공용 지식 하나가 필요합니다. 전제가 하나 있습니다. 이 방법은 아무 도메인에나 통하지 않습니다. 산업 표준이 존재하는 도메인에 한합니다. 출발점이자 한계입니다. 지도와 골목 주석: 두 개의 층 시맨틱 레이어는 AI가 읽는 도메인 사전입니다. 모델도 아니고 DB도 아닙니다. 낯선 코드나 테이블, 로그, 에러를 만났을 때 “이게 업무적으로 뭔가”를 통역해주는 나침반입니다. 이걸 두 층으로 쪼갠 게 핵심입니다. Core (범용): 산업 표준에 기반해 어느 회사에나 통용되는 층입니다. 국제 도메인 표준이 근거이고 거의 바뀌지 않습니다. Overlay (조직): 우리만의 프로세스와 규칙, 예외를 담는 층입니다. 근거는 실무에서 축적된 도메인 지식이고 자주 바뀝니다. 규칙은 하나뿐입니다. Overlay는 Core를 고치지 않고 ID로 참조만 합니다. 표준 세계 지도(Core) 위에 우리 동네 골목 주석(Overlay)을 얹는 셈입니다. 지도는 전 세계 공통이라 누구나 읽고, 골목 사정은 우리만 압니다. AI는 골목 주석을 만나면 참조 링크를 따라 표준 지도까지 함께 펼쳐 답합니다. “이건 우리 고유의 X 처리인데, 표준으로는 Y에 해당해요.” 이 분리가 주는 이점이 셋입니다. 표준인 Core는 다른 팀에도 그대로 재사용됩니다. 자주 바뀌는 건 Overlay뿐이라 유지보수가 가볍습니다. “이건 표준 근거, 이건 조직 특화”가 늘 또렷하게 남습니다. 다만 뒤에서 다시 말하겠지만 이 세 가지는 아직 실측이 아니라 설계 의도입니다. 그래서 실제로 어떻게 생겼나 추상적으로 들릴 수 있으니 형태를 밝히면 이렇습니다. Core와 Overlay는 둘 다 사람이 읽을 수 있으면서 AI도 쉽게 파싱하는 구조화 문서입니다. 각 개념은 문장 뭉치가 아니라 필드를 가진 항목입니다. 안정적인 ID, 설명, 관련 엔티티, 상태(state), 참조 관계를 갖습니다. Overlay의 각 항목은 relates_to 같은 필드로 자신이 대응하는 Core 개념을 명시적으로 가리킵니다. 산문이 아니라 연결된 개념 그래프인 셈입니다. 뒤에 나오는 "잘 쓴 문서와 뭐가 다른가"에 대한 답도 여기서 나옵니다. 어떻게 만들었나: 세 개의 기둥 1. 표준을 Core로, 사실은 ‘표준 조각을 편집하는’ 일 여기서 솔직해야 할 대목이 있습니다. 이 도메인에 깔끔한 단일 국제 표준이 하나 있어서 그걸 가져다 쓴 게 아닙니다. 실제로는 식별
 NHN Cloud Meetup
 > 본 콘텐츠는 작성자가 사내 게시판에 공유한 글을 가공한 것으로, 작성자의 의도와 맥락을 충실히 전달하기 위해 원문의 문장 스타일을 그대로 유지하였습니다. --- 우리는 에이전트 코딩의 황금기를 살고 있다. 그리고 그 사실을 모르고 있다. 매달 전 세계의 개발자들이 Claude에 정액제를 결제한다. 2만 원, 10만 원, 20만 원. 이 싼값에 인류 역사상 가장 정교한 추론 엔진을 거의 무제한으로 사용할 수 있다. 간단한 코드베이스 탐색에도 에이전트를 다섯 개씩 동시에 띄운다. 변수 이름 하나 바꾸자고 백만 토큰 짜리 모델을 호출한다. OMC가 컨텍스트 윈도우를 활활 태워도 개의치 않는다. 클로드 코드는 따습고, 토큰은 "공짜"니까. 그런데, 정
신생 회사였습니다 딜라이트허브(DelightHub) 태동기 새로운 성을 짓는 것과 다름 없었던, 딜라브 스쿼드 저는 신생 스쿼드를 여러 번 거쳤습니다. 섭스, 슬립, 코어, 바이럴, 인디아, 리워드… 스쿼드 이름을 하나씩 되짚다 보면 제 지난 몇 년이 그려지지요. 새 스쿼드가 뜨면 들어가서 기틀을 잡고, 성과를 내고, 다음으로 넘어갔습니다. 그러니 이번에도 그러려니 했습니다. 익숙한 일이라 여겼거든요. 허나 딜라브 스쿼드는 사뭇 달랐습니다. 여러 제품을 한꺼번에 안았고, 그 제품들은 우리가 만든 것이 아니라 사온 것이었습니다. 다른 유저, 다른 환경, 심지어 다른 법인으로의 이관까지. 익숙한 스쿼드가 아니라, 바닥부터 회사 하나를 새로 짓는 느낌이었지요. 여러 번 해봤는데도 처음 같았던 셈입니다. 우당탕탕 토대를 쌓으면서 성과를 만들어낸 분기. 그 우당탕탕이 지나간 자리에 세 가지가 남았습니다. A. PMI. 토대를 쌓다. PMI = Post Merge Integration. 인수 이후의 일들. 계약서에 사인하는 순간 딜이 끝난다고 생각하기 쉽습니다만, 사실은 거기서부터가 진짜 노동입니다. 이번 분기 PMI에는 화려한 것이 하나도 없었습니다. 대신 터지는 것이 참 많았습니다. 대부분이 매도자 환경에 묶여 있던 것을 우리 환경으로 옮기는 작업이었습니다. 앱·콘솔 계정을 우리 콘솔로, 서버·인프라를 우리 스택으로, DB를 우리 DB로. 말로 적으면 세 줄인데, 옮기는 매 순간이 사건이었습니다. 아침에 눈을 뜨면 항상 무슨 일이 터져있었습니다. 갑자기 구글 결제가 막히질 않나, 유저들의 학습 콘텐츠가 서빙이 끊기질 않나, 이벤트 로깅도 잘 되던 것이 모종의 이유로 유실이 되거나 잘못 로깅되기 일쑤였습니다. 적게 잡아 분기 동안 매일 1개씩, 총 90개 이상의 이슈가 있었던 것 같네요. 이 모든 것을 팀 전체가 합심해서 잘 해결해내고 있습니다. AI 에이전트 Petr의 도움도 컸구요. 5월 한 달 머지된 제품 코드의 40% 넘는 비중을 Petr이 소화했거든요. 사람 손이 닿아야 할 곳에 사람이 붙고, 반복되는 곳에 에이전트가 붙었습니다. PMI의 성과는 문제가 안 보이게 되는 것으로 측정됩니다. 잘 되면 아무 일도 없지요. 그 ‘아무 일 없음’을 만드는 것이 일이었고, 이번 분기에 그 토대를 거의 다 쌓았습니다. B. LTV > CAC : 지속 성장 가능한 구조를 갖춰가다. 토대가 잡히면 진짜 질문이 옵니다. 이 제품이 계속 굴러갈 수 있는 구조인가. 한 명의 유저가 벌어다 주는 돈(LTV)이, 그 유저를 데려오는 비용(CAC)보다 커야 한다. 당연한 말 같습니다만, 이걸 실제 숫자로 만드는 것이 이번 분기의 핵심이었습니다. b-1. LTV를 끌어올리다 LTV는 CVR(구독 전환율), ARPPU(결제 유저당 평균 매출)로 분해됩니다. 여기에 가장 많은 시간을 썼습니다. 온보딩을 개편했고, 가격 실험을 1차부터 3차까지 돌렸습니다. 할인 페이월에 타이머를 붙였고, 핵심 페이월 동선을 다시 짰지요. 결과는 명확했습니다. ARPPU가 3배로 뛰었습니다. 연구독 비중을 끌어올린 것이 컸습니다. 대신 무료체험을 붙이면서 CVR은 0.6배로 떨어졌고요. 전환율을 일부 내주고 객단가를 크게 가져온 셈입니다. 곱하면 LTV 1.8배. 무서웠던 3배 가격도, 겁났던 전환율 하락도, 부등식 안에서 계산해보면 명백한 순증이었습니다. 그로스란 홈런이 아니라 출루의 누적이지요. 가격 하나, 트라이얼 하나, 타이머 하나가 쌓여 1.8배가 된 것입니다. CAC를 낮추기 위한 기반 작업들도 제품단에서 선행되었습니다. 웹에서 계정 생성 없이 온보딩부터 결제까지 가능하게 만들었고, 핵심 마케팅 소재가 될 Image Occlusion 기능 플로우를 개선했고, 스토어 평점을 담당할 인앱 Rating 플로우를 다듬었습니다. b-2. CAC를 낮추다 데려오는 비용도 손봤습니다. 기본 스토어 셋업과 MMP 연동을 마쳤고, Image Occlusion과 프리메이드 덱을 마케팅 소재로 검증했고, 웹과 앱 각각의 레슨을 만들었습니다. 틱톡 뿐 아니라 Meta와 Goo
모바일 E2E 테스트 자동화를 떠올리면 처음 목표는 대개 단순합니다. 사람이 직접 확인하던 시나리오를 자동으로 돌리고, 실패하면 리포트를 남긴다. 여기까지가 출발점입니다. 저희도 비슷하게 시작했습니다. PetFriends 모바일 앱의 주요 시나리오를 Appium으로 자동화하고, GitHub Actions에서 iOS와 Android 테스트를 실행하고, Mochawesome 리포트를 남기는 구조를 만들었습니다. 로그인, 결제, 검색, 카테고리, 마이페이지, 상품상세 같은 흐름을 시나리오 테스트로 구성했고, 정기 실행과 수동 실행을 모두 지원하도록 했습니다. 그런데 실제로 운영해보니 병목은 테스트 실행 자체가 아니었습니다. 테스트는 어떻게든 돌릴 수 있습니다. 어려운 건 실패한 뒤였습니다. 실패가 앱 문제인지, 테스트 코드 문제인지, 실행 환경 문제인지 판단하고 기록하는 일이 매번 사람 몫으로 남았습니다. 테스트 자동화가 “실행”을 넘어 “운영”의 문제가 된 순간이었습니다. 앞선 글에서는 Appium으로 웹뷰 테스트를 구현하는 과정과 GitHub Actions, self-hosted runner 기반의 E2E 자동화 구축 과정을 다뤘습니다. 이 글은 그 다음 이야기입니다. 테스트를 어떻게 작성하고 실행 환경을 어떻게 만들었는지보다, 실제 운영 단계에서 왜 GitHub Actions와 n8n의 책임을 나눴는지, 어떤 기준으로 경계를 그었는지, 그리고 이 구조가 이후 AI 기반 분석과 Self-Healing의 기반이 된 이유를 정리합니다. 이전 글에서 출발한 구조 출발점은 이미 구축해둔 Appium E2E 실행 환경이었습니다. Appium, WebdriverIO, TypeScript, Mocha, Mochawesome 조합으로 iOS와 Android 시나리오를 실행하고, GitHub Actions의 self-hosted runner에서 디바이스 자원과 Appium 서버를 관리하는 구조였습니다. 실행 흐름은 아래처럼 단순화할 수 있습니다. GitHub Actions ├─ checkout ├─ pnpm install ├─ runner 환경 초기화 ├─ Appium 서버 상태 확인 ├─ iOS 또는 Android 시나리오 실행 ├─ 인프라 오류 여부 확인 ├─ Mochawesome 리포트 생성 확인 ├─ 녹화 artifact 업로드 ├─ HTML 리포트 배포 └─ webhook으로 결과 전송 여기까지만 보면 자동화가 어느 정도 완성된 것처럼 보입니다. 테스트가 실행되고, 리포트가 남고, 성공과 실패도 확인할 수 있으니까요. 하지만 운영을 시작하면 곧 다른 질문들이 생깁니다. 이 실패는 제품 결함인가, 테스트 코드 결함인가? 같은 실패가 최근에도 있었나? 실패한 시나리오의 리포트와 GitHub Actions run은 어디에 있나? 정기 실행 결과는 Notion에 남겼나? Slack 알림은 누가 보내고, 어떤 포맷으로 보내야 하나? 실패를 AI로 분류하려면 어디에서 호출해야 하나? 나중에 알림 채널이나 리포팅 대상을 바꾸려면 어디를 수정해야 하나? 이 질문들까지 GitHub Actions 안에서 해결하려고 하면 workflow가 금방 복잡해집니다. 실행 스크립트와 운영 규칙이 섞이고, 작은 알림 변경에도 PR이 필요해집니다. 경계만 코드로 보면 더 명확하다 GitHub Actions가 어디까지 맡는지 코드 경계로 보면 더 명확합니다. name: Mobile E2E Scenario Test on: workflow_dispatch: inputs: platform: description: ios | android required: true scenario_group: description: 시나리오 그룹 (비우면 전체 실행) required: false jobs: scenario-test: runs-on: self-hosted # 모바일 디바이스와 Appium 서버는 동시에 여러 세션이 붙으면 불안정해질 수 있다. # 그래서 테스트 세션 단위로 동시 실행을 제한한다. concurrency: group: mobile-e2e-session
안녕하세요. 펫프렌즈 Post-Order 팀 백앤드 개발자 테디입니다. 저의 첫 기술 블로그 포스팅으로 Post-Order 팀의 10번째 동료인 “만득이” 를 소개시켜 드리고자 합니다! 만득이는 펫프렌즈 내 Post-Order 팀에서 주문/결제/쿠폰 도메인과 사용자 도메인 업무를 돕는 봇입니다. 주문, 결제, 배송, 쿠폰, 포인트, 클레임처럼 주문 이후에 이어지는 흐름과 사용자, 인증, 주소, 약관, 메시지 같은 사용자 도메인 질문을 주로 검토합니다. 필요할 때는 코드, Jira, Notion, Slack 히스토리, Sentry, OpenSearch 에서 근거를 확인하고, 확인한 사실과 추정을 나눠 답하는 역할을 하고 있습니다. 만득이를 만들고, 처음 대화했던 순간 한 달차 봇에게 업무를 맡긴다는 건 살짝 위험한 일입니다. 아직 수습 티가 나고, 가끔은 자신이 아는 것과 확인한 것을 헷갈릴 수 있기 때문입니다. 그래도 한 달 동안 Post-Order 팀원들이 PR 코드 리뷰, 장애 조사, 로그 확인, Jira 와 Notion 문서 확인, Slack 질의응답을 시켜보니 꽤 선명해진 결론이 하나 있습니다. 좋은 업무용 LLM 봇은 모델 하나로 만들어지지 않는다. 모델을 둘러싼 하네스가 봇의 실제 품질을 결정한다. 업무 관련 질문이 하네스와 모델을 거쳐 검증된 답변으로 정리되는 흐름 그림 1. 모델이 바로 답하는 구조가 아니라, 하네스가 앞뒤에서 범위와 근거를 잡아주는 구조입니다. 여기서 하네스는 단순한 실행 스크립트가 아닙니다. 어떤 질문에 답할 수 있는지 정하는 범위, 어떤 근거를 먼저 확인할지 정하는 순서, 실패했을 때 어디까지 공유할지 결정하는 안전 장치, 같은 실수를 반복 하지 않게 만드는 기억 생성과 교정 루프까지 포함합니다. 이번 포스팅에서 다루는 내용 이 포스팅 에서는 “만득이가 어떤 모델 위에서 동작 하는가” 보다 “업무용 봇이 안정적이고 효율적으로 동작 하려면 어떤 하네스가 필요한가” 에 더 초점을 둡니다. Post-Order 업무에서 만득이가 실제로 맡은 일: PR 코드 리뷰, 운영 로그/문서 조사, Slack 질의응답, Notion/Jira 정리 왜 모델 호출 루프보다 컨텍스트와 피드백 루프가 더 중요해지는지 Codex 런타임이 Claude 계열 봇과 구조적으로 어떻게 다른지 한 달차 봇이 아직 조심해야 할 것들 Slack 에서 확인한 실제 사용 사례 실제 사용 사례는 포스팅 아래쪽에 “실제 Post-Order 팀에서 어떻게 쓰였나” 에서 따로 정리했습니다. Post-Order 에서 먼저 만난 문제들 만득이는 처음부터 범용 챗봇으로 쓰인 것이 아닙니다. 주로 주문 이후 흐름과 사용자 도메인 옆에서 반복적으로 호출됐습니다. PR 에서 주문, 쿠폰, 클레임 흐름의 회귀 가능성을 찾기 Sentry 와 OpenSearch 로그를 보고 장애 범위와 원인 후보를 분리하기 Jira, Notion, Slack 히스토리에서 정책의 현황과 출처를 확인하기 긴 설명은 Notion 에 정리하고, Slack 에는 결론과 링크만 남기기 Sync PR 생성이나 PR 코드 리뷰 및 리뷰 확인처럼 반복되는 운영 작업을 안전하게 처리하기 이런 일은 모델이 문장을 잘 쓰는 것만으로는 부족합니다. 질문의 범위, 근거의 출처, 사용했던 도구의 상태, 답변 해도되는 정보와 노출하면 안 되는 정보를 매번 나눠야 하기 때문입니다. 대표 사례를 하나만 먼저 꺼내보면, 주문 프로젝트 레포지토리에 master -> develop/stage sync PR 을 생성하는 요청이 있었습니다. 겉으로는 단순한 PR 생성 이지만 실제로는 기준 브랜치, 대상 브랜치, 기존 PR 중복 여부, 충돌 여부, 라벨 할당 여부, 최종 링크 공유까지 해야 하는 작업이었습니다. 이 흐름에서 중요한 것은 모델이 PR 본문을 잘 작성하는 능력보다, 하네스가 어떤 쓰기를 허용하고 어디서 멈춰야 하는지를 정해주는 구조였습니다. 하네스 엔지니어링이란 무엇인가 하네스 엔지니어링은 AI 에이전트가 복잡한 업무를 안정적으로 수행하도록 모델 밖의 환경을 설계하는 일입니다. 여기에는 어떤
Spring Data JDBC Composite PK를 쓰고 싶었을 뿐인데, Batch·Kotlin·Jackson·Gradle까지 함께 정리하게 된 이야기 안녕하세요. 네이버페이 카드 BE 팀 오규석 입니다. 네이버페이에서 카드결제 매입/정산 개발을 담당하고 있습니다. 이 글은 카드 매입/정산 배치 모듈을 Spring Boot 3.5.0 → 4.0.1로 업그레이드하면서 만났던 시행착오와 진행과정을 정리한 기록입니다. 📝 용어 한 줄 정리 이 글에서는 같은 대상을 두 가지로 부릅니다. Composite PK는 DB 관점에서 PK가 여러 컬럼으로 구성된 키를 가리키고, Composite ID는 이 PK를 Spring Data JDBC에서 표현한 ID 클래스 매핑을 가리킵니다. 즉 “DB의 Composite PK를 Spring Data JDBC의 Composite ID로 매핑하는 작업” 이라고 보시면 됩니다. 먼저 요약하면 시작은 Spring Data JDBC의 Composite ID 적용이었습니다. 실제 작업은 Spring Boot 4 / Spring Framework 7 / Spring Batch 6 / Jackson 3 전환으로 확장되었습니다. 가장 큰 변경은 Batch 메타데이터 저장 방식, Job 실행 API, JobParameters 구조, listener·item 패키지 이동이었습니다. 운영 반영 전에는 Spring Batch v5에서 실패한 JobExecution 정리, Batch 메타 스키마 마이그레이션, DB 접근 정책 확인이 필요했습니다. 메이저 업그레이드는 “컴파일 통과”보다 “운영에서 기존과 동일하게 동작하는지”를 확인하는 작업에 가까웠습니다. 이 글의 전제 이 글은 실제 업그레이드 작업 당시 적용한 Spring Boot 4.0.1 버전 기준의 기록입니다. 이 글을 읽으시는 시점에는 더 최신 패치 버전이 있을 수 있고, Spring Boot 4 / Spring Batch 6은 패치 버전에 따라 세부적인 내용이 이 글과 차이가 있을 수 있습니다. 이 글에서 나오는 코드는 실제 프로젝트 코드가 아닌 상황을 단순화한 예제입니다. 또한 이 글은 일반적인 Spring WAS 서버가 아니라, Spring Batch Application 모듈 업그레이드이니 일반적인 Spring 서버 업그레이드시에는 추가 사항이 필요할 수 있습니다. 이 글은 다음 환경을 기준으로 작성했습니다. (화살표(→) 앞은 업그레이드 전, 뒤는 업그레이드 후 버전입니다) Spring Boot 3.5.0 → 4.0.1 (Spring Framework 6.2.7 → 7.0.2) Spring Batch 5.2.2 → 6.0.1 Spring Data JDBC 3.5.0 → 4.0.1 Kotlin 2.1 → 2.3 Java 21 ojdbc8 → ojdbc11 kotest 5.9.1 → 6.0.7 spring-boot-starter-aop → spring-boot-starter-aspectj Oracle DB에 JDBC 기반 Spring Batch 메타데이터 저장 📖 이 글을 읽는 법 글이 다루는 범위가 꽤 넓습니다. 관심사에 따라 다음 순서로 골라 읽으셔도 됩니다. - Spring Data JDBC Composite ID가 뭔지 궁금하다면 → 1장 - Spring Batch 6 마이그레이션이 주 목적이라면 → 3장 - 운영 반영 체크리스트가 필요하다면 → 5장과 마지막 체크리스트 참고한 공식 문서 - Spring Boot Upgrading Guide — https://docs.spring.io/spring-boot/upgrading.html#upgrading.from-3x - Spring Boot 4.0 Migration Guide — https://github.com/spring-projects/spring-boot/wiki/Spring-Boot-4.0-Migration-Guide - Spring Boot Release Notes — https://github.com/spring-projects/spring-boot/wiki#release-
안녕하세요 SpoonLabs 에서 Business Platform Team 백엔드 서버 개발을 맡고있는 Joe(원주호) 입니다. 저는 iOS 앱의 주 수익원인 인앱 결제에 관해서 이야기를 하려고 합니다. 인앱 서비스 느낌? iOS 인앱 결제에 대해 먼저 이야기 해보자 iOS 앱에서 유료 콘텐츠를 판매하려면 대부분 Apple의 인앱 결제(In-App Purchase)를 사용하게 됩니다. 이건 단순히 결제 수단 하나를 붙이는 문제라기보다, 결제와 환불, 그리고 그 이후의 모든 흐름을 Apple의 시스템 안으로 맡기는 선택 입니다. 사용자가 앱에서 상품을 선택하고 결제를 누르면, 실제로 돈이 오가는 순간은 서비스가 아니라 Apple App Store에서 일어납니다. 결제 승인, 카드 정보 처리, 영수증 발급까지 모두 Apple의 책임이며, 서비스는 그 결과를 받아서 “이 사용자가 무엇을 샀는지”를 확인하고 구매에 대한 서비스내 재화를 지급하는 역할을 맡습니다. 조금 더 보태어 말하면, 앱 서비스 제공자는 결제를 직접 처리하지 않습니다. 대신 Apple이 “결제는 완료됐다”고 알려주면, 그 말을 믿고 아이템을 지급하거나 구독 권한을 열어주는 구조입니다. 결제 흐름은 어떨까? 흐름 자체는 복잡하지 않습니다. 앱 접속 - 결제 상품 선택 - iOS가 익숙한 App Store 결제 화면 노출 - 결제 끝 (Apple 의 영수증을 발급) 그 다음 부터가 서비스의 역할입니다. 이 영수증 (또는 결제 주문번호 등)을 서버에서 검증하고, 문제가 없으면 해당 사용자에게 구매 상품에 대한 아이템 또는 권한을 제공합니다. 여기까지 보면 꽤 깔끔한 구조처럼 보입니다. 사용자는 안전하게 결제할 수 있고, 서비스는 민감한 결제 정보를 직접 다루지 않아도 됩니다. Apple이 제공하는 이 구조 덕분에 iOS 결제 경험이 일관되게 유지되는 것도 사실입니다. 하지만 결제와 관련된 모든 최종 결정권은 Apple이 가진다는 점입니다. 서비스는 결제를 승인하거나 거절할 수 없고, 환불 역시 서비스가 아니라 Apple의 정책에 따라 처리됩니다. 사용자가 환불을 요청했는지, 어떤 사유로 승인되었는지조차 서비스 입장에서는 알기 어려운 경우가 많습니다. 이건 단순한 기술적 제약이라기보다, Apple이 사용자 경험과 소비자 보호를 최우선에 두고 설계한 결과에 가깝습니다. 사용자는 앱마다 환불 정책을 찾아다닐 필요 없이 Apple 계정 하나로 결제 내역과 환불을 관리할 수 있고, 문제가 생기면 서비스가 아니라 Apple에 바로 요청할 수 있습니다. 그럼 진짜 문제는 무엇인가? 진짜 문제는 Apple 이 제공하는 IAP 시스템을 악용하는 유저가 존재한다는 것입니다. 사용자 아이템 구매 후 전부 소진 상태 이후 서비스에 어떤 요청도 하지 않은 채, Apple에 직접 인앱 결제 환불을 요청하는 상황입니다. 그리고 이 환불은 Apple 기준으로는 정상적인 절차입니다. 문제는 그 환불이 처리되는 동안, 혹은 처리된 이후에도 서비스는 그 사실을 즉시 알지 못할 수 있다는 점입니다. 환불은 끝났는데, 사용자는 여전히 아이템을 쓰고 있고, 구독 권한도 살아 있고, 서비스는 아무 일도 없었다는 듯 정상적으로 리소스를 제공합니다. 사용자 입장에서는 환불을 받았고, Apple 입장에서도 정책에 맞게 처리했다. 하지만 서비스 입장에서는 그제야 질문이 생깁니다. “이 상황을 언제, 어떻게 알아야 했을까?” 환불을 “알 수 있는” 거의 유일한 방법 이 질문에 대한 답을 찾다 보면, 결국 하나의 기능으로 수렴하게 됩니다. 바로 App Store Server Notifications입니다. Apple은 인앱 결제와 관련된 주요 상태 변경이 발생했을 때, 해당 이벤트를 서버 간 통신 방식으로 전달해주는 기능을 제공하는데 결제 완료, 구독 갱신, 해지, 그리고 우리가 관심을 가질 수밖에 없는 환불 관련 이벤트 역시 여기에 포함이 됩니다. 중요한 점은, 이 알림이 앱으로 오는 것이 아니라 서비스 서버로 직접 전달된다는 것입니다. 즉, 환불을 포함한 결제 상태 변화는 “사용자가 앱을 실행했을 때”가
주니어 데빈(devin)과 클로드(claude) 올해 들어 제품 내에서 살펴야 할 피처의 넓이와 깊이가 모두 깊어졌고, 인수한 제품의 특성상 우리가 아직 모르는 동작도 훨씬 많았습니다. 와중에 2개의 스쿼드의 PO 역할을 담당하려다 보니 물리적으로 혼자 감당할 수 있는 범위를 이미 넘어선 상황에서, 두 주니어 AI 가 빈자리를 꽤 단단하게 채워줬습니다. Devin은 코드베이스를 꿰뚫는 주니어 Dev Claude는 제품 로드맵 구축부터 백로그 배포 이후의 후속 기획까지 함께 뛰는 주니어 PO Devin : 코드 및 데이터베이스를 꿰뚫는 주니어 Dev Devin에게 부여하는 역할은 크게 네 가지입니다. [Reader] “이 기능 지금 어떻게 동작해?” 하고 물으면 코드를 읽고 플로우를 정리해 주고, 관련 수치까지 뽑아줍니다. 복잡한 코드를 대신 읽고 구조화해 주기 때문에, 기획 단계에서 많은 리소스를 아낄 수 있습니다. 인수한 제품이라 우리가 모르는 동작이 훨씬 많은 환경에서는 특히 유용합니다. [Debugger] 문제가 터졌을 때 원인을 함께 디깅 합니다. 영향을 줄 수 있는 코드 내 다양한 변인을 같이 검토해 주고, 과거 커밋 히스토리까지 알고 있기 때문에 “이전에는 어떻게 동작했는지”도 추적할 수 있습니다. [Developer] 간단한 코드 수정은 직접 해주기도 합니다. 물론 더 대단한 개발도 해주기야 하겠지만, 아직은 그 결과물을 온전히 신뢰하기 어려운 단계입니다. (그가 책임을 지지는 못하기 때문에…) 운영상의 불편함을 한 번의 코딩으로 갈음해 주는 역할도 해주곤 합니다. 사실 이 역할을 더 많이 활용해야 하는데, 이번 분기에는 미진했네요. 다음 분기를 기약해 봅니다. 아무래도 백로그가 잔뜩 쌓여있을 때 더 빛을 발할 것 같네요. [DA] 예상 임팩트 계산, 코호트 분석, 교차 분석도 수행합니다. 매출 데이터만 해도 웹 결제냐 앱 결제냐에 따라 참고해야 할 소스가 다르고, 유저 액티비티 값 역시 서버 값과 클라이언트 값을 잘 교차해서 써야 합니다. Devin은 AMP, Stripe, Qonversion 등 여러 데이터 소스를 넘나들며 이걸 해주고, taxonomy도 이미 파악하고 있어서 매번 설명할 필요가 없습니다. 또한 때로는 무의미해 보일 수 있을 정도로 세세한 데이터 분석을 해보고 싶을 때가 있는데 (간혹 그 속에서 좋은 시드를 찾을 때가 있긴 하니까) 그럴 때도 데빈이는 묵묵히, 또 빠르게 결과 값을 가져다주어 속 시원함을 제공해주기도 합니다. Claude : 제품 전략부터 기획까지 함께하는 주니어 PO Claude의 메인 역할은 세 가지입니다. [Discussion Partner] 가장 많이 쓰는 역할입니다. 문제 정의가 틀어졌을 때, 더 나은 대안이 있을 때, 논리에 구멍이 있을 때, 리스크를 놓쳤을 때 — 대화를 통해 잡아냅니다. 실제로 백로그 검토 및 쟁점 정리, 온보딩 이후 문제 정의와 솔루션 기획, 스쿼드 회고 정리, 온보딩 플로우 재구성 등 다양한 국면에서 이 역할을 활용했습니다. [Document Editor] 저는 맥락을 최대한 주기 위해 raw data를 통째로 던지는 편입니다. 두서없이 적어 내려 간 사고 흐름, 유저 인터뷰 원문, 서베이 응답 같은 날것의 데이터를 문서 목적에 맞게 정리해 줍니다. 대부분의 PRD와 분석 문서 등 주요 문서들은 클로드가 작성해 주죠. 특히 이번 분기는 영어권 국가 유저 인터뷰를 진행하느라 영어 <> 한국어 간 넘나듦이 문서상에서도 빈번했는데, 알아서 어련히 깔끔하게 잘해주니 이보다 든든할 수 없었죠. [DA] 주어진 데이터와 기획 의도, 맥락을 기반으로 가설을 검증하고 후속 액션 아이템을 뽑아줍니다. 데빈이가 실제 코드 베이스와 데이터베이스를 넘나들 수 있는 역량이 있다면, 클로드는 그걸 읽고 해석하는 두뇌가 더 명석합니다. 둘의 합작으로 유의미한 분석 결과들을 내주고 있습니다. 데빈이가 필요한 데이터 뽑아주고, 클로드가 전체 맥락에서 정리해 주고 - 마이너 한 활용도 있습니다. [Visualizer] 로서 그래프, 다이어그램, 발표 자료 같은 것들
ChatGPT Apps SDK와 MCP(Model Context Protocol)로 요기요 배달 서비스를 연동한 프로젝트의 기술적인 설계와 구현, 그리고 개발 과정에서 얻은 인사이트를 공유합니다. 1. 왜 ChatGPT App인가 약 1년 전쯤, 한 경제 유튜버가 “곧 모든 앱이 AI로 대체되는 시대가 온다”며 배달 앱을 예로 든 적이 있었습니다. 배달 앱을 열어서 카테고리를 누르고, 가게를 고르고, 메뉴를 스크롤 하는 대신 — AI에게 “오늘 매운 거 먹고 싶어”라고 말하면 메뉴 추천부터 주문까지 한 번에 처리해 주는 세상이 올 거라는 이야기였습니다. 배달 플랫폼을 개발하는 입장에서 그 영상을 보면서 든 생각은 솔직히 회의적이었습니다. 수만 개 레스토랑의 메뉴 정보, 실시간 배달 가능 여부, 라이더 매칭, 결제 처리 — 이 모든 걸 AI가 어떻게 다 처리한다는 거지? 배달 플랫폼이 직접 데이터와 기능을 열어주지 않는 한 불가능할 텐데 라고 생각했습니다. 그런데 2025년 12월, ChatGPT Apps가 출시되면서 그 “불가능”이 현실이 되는 구조가 만들어졌습니다. OpenAI가 제공하는 MCP(Model Context Protocol) 와 Apps SDK를 통해, 외부 서비스가 자신의 데이터와 기능을 ChatGPT에 연결할 수 있는 표준 인터페이스가 열린 것입니다. AI가 혼자서 배달 서비스를 만드는 게 아니라, 배달 플랫폼이 MCP 서버를 통해 도구(Tool)를 제공하면 ChatGPT가 대화 맥락에 맞춰 그 도구를 호출하는 구조 — 결국 플랫폼이 정보를 열어야 가능하다는 그때의 생각이 맞았고, MCP가 바로 그 “여는 방법”을 표준화한 프로토콜이었습니다. 여기서 주목할 점은 MCP 자체와 ChatGPT App의 차이입니다. 기존 MCP는 REST API처럼 AI가 외부 시스템의 기능을 호출할 수 있도록 Tool을 확장하는 프로토콜입니다. AI가 Tool을 호출하면 JSON 형태의 데이터를 받아서 텍스트로 요약해 응답하는 구조 — 결국 사용자가 보는 것은 텍스트뿐이었습니다. 그런데 ChatGPT Apps SDK는 여기에 위젯(Widget) 이라는 레이어를 추가했습니다. MCP 서버가 Tool 응답에 _meta.outputTemplate이라는 메타데이터를 포함하면, ChatGPT가 단순 텍스트 대신 HTML 기반의 인터랙티브 UI를 대화 안에 인라인으로 렌더링합니다. 사용자는 이 위젯 안에서 지도를 드래그하고, 가게를 클릭하고, 메뉴를 스크롤 하고, 주문 버튼을 누를 수 있습니다. 텍스트 응답을 읽는 것이 아니라 서비스와 직접 상호작용하는 경험이 가능해진 것입니다. 이제 사용자는 “강남역 근처 치킨 배달 가능한 곳 알려줘”라고 대화하는 것만으로, ChatGPT가 요기요의 레스토랑 검색 Tool을 호출하고, 그 결과를 가게 리스트·상세 정보·메뉴·리뷰·지도 같은 위젯으로 바로 보여줄 수 있게 됩니다. 기존 요기요 앱/웹의 전체 기능을 그대로 옮기는 것이 아니라, 대화 흐름 속에서 필요한 데이터만 Tool로 가져오고, 그에 맞는 UI를 위젯으로 렌더링하는 구조 — 이것이 이 프로젝트가 만들고자 한 경험이었습니다. 2. 개발 환경 세팅 ChatGPT App을 개발하고 테스트하려면 먼저 몇 가지 환경이 갖춰져야 합니다. ChatGPT 워크스페이스 또는 Pro 계정: 개발 앱을 등록하고 테스트하려면 ChatGPT 개발자 워크스페이스 접근 권한이 있는 계정이 필요합니다. 무료 플랜에서는 개발 앱 등록이 불가능합니다. 퍼블릭 도메인 또는 터널링 서비스: ChatGPT가 MCP 서버에 접속해야 하므로, 외부에서 접근 가능한 HTTPS 엔드포인트가 필요합니다. 프로덕션이라면 도메인과 SSL 인증서를, 로컬 개발이라면 ngrok 같은 터널링 서비스를 사용하여 로컬 서버를 외부에 노출합니다. Registering a Dev version app to the workspace 개발 앱의 Tool 갱신: 개발 앱으로 등록된 상태에서는 MCP 서버의 Tool 정의를 수정한 뒤, ChatGPT 대화창에서 새로고침만 하면 변경된 Tool 목